高性能计算服务
>
软件专区
>
最佳实践
>
在超算互联网国产加速卡上使用 ProteinMPNN 进行蛋白质序列设计
给定蛋白质主链结构,如何快速得到一组与该结构相容的氨基酸序列?ProteinMPNN 将主链几何信息作为条件,通过图神经网络进行序列设计。它适用于固定骨架重设计、局部位点优化和多链复合物序列设计。本实践使用超算互联网已公开的 ProteinMPNN 1.0.0 镜像,在单张国产异构加速卡上完成单结构设计、批量设计和固定链及残基设计,并检查生成文件是否满足预期。
全文以使用现成镜像为主。读者无需重新安装 PyTorch 或下载模型权重;构建与适配要点放在附录。输入选用 ProteinMPNN 官方仓库公开算例,不涉及未公开的研究数据。模型方法参见 Dauparas 等发表于 Science 的 ProteinMPNN 论文及官方仓库。[1][2]
在超算互联网的 AI 社区镜像库中搜索作者 daydreamer06 发布的 proteinmpnn,选择 1.0.0 版本。公开镜像的完整拉取命令为:
docker pull appstore.scnet.cn:5000/aihub/dcu/daydreamer06/proteinmpnn:1.0.0这条命令用于标识镜像或在具备相应容器运行环境时拉取镜像。本文的操作入口是平台 Notebook;进入该镜像创建的 Notebook 后,直接执行后续命令,无需在 Notebook 内再次执行 docker pull。
本次实测日期为 2026 年 10 月 20 日,采用单卡 Notebook 实例。下表记录实例内实际读取的配置,方便读者判断结果适用范围。
| 项目 | 实测配置 |
|---|---|
| 加速卡 | K500SM_AI 单卡,显存约 64 GiB |
| CPU 与内存配额 | 7 个 CPU 核,110 GiB 内存 |
| 操作系统 | Ubuntu 22.04.5 LTS |
| Python | 3.11.9 |
| PyTorch 与 NumPy | 2.9.0 与 1.25.0 |
| DTK 与 HIP | DTK 26.04,HIP 6.3.26093 |
| 模型权重 | vanilla_model_weights/v_48_020.pt |
| 推理线程 | OMP、MKL、OpenBLAS 均设为 4 |
上述配置是本次实例的实际配额,不代表 ProteinMPNN 的最低资源要求。本文的三个小规模算例无需多卡;如计划处理超长链或大量复合物,应先以小批量试跑,再按显存和耗时调整规模。
在镜像详情页进入快速开发并创建 Notebook,选择可用区域、国产异构加速卡及单卡配置,等待实例运行后打开 JupyterLab。也可以从控制台 Notebook 创建页面选择已公开镜像。平台页面会随版本调整,创建入口及资源选择以平台的 Notebook 使用说明为准。[3]
在 JupyterLab 的启动页选择“终端”。后续代码块均在终端中执行;只有 Notebook 界面也能完成本文全部操作。若浏览器出现 Jupyter 的 token 登录页,应使用平台提供的访问方式或实例的 Jupyter token,不能把平台链接中的 userToken 当成 Jupyter token。访问令牌及完整临时链接不应放入公开教程或截图。
source /opt/dtk-26.04/env.sh
export OMP_NUM_THREADS=4
export MKL_NUM_THREADS=4
export OPENBLAS_NUM_THREADS=4
proteinmpnn --help
python - <<'PY'
import torch
print("PyTorch:", torch.__version__)
print("加速卡可用:", torch.cuda.is_available())
print("加速卡数量:", torch.cuda.device_count())
if torch.cuda.is_available():
    print("加速卡名称:", torch.cuda.get_device_name(0))
PY
本镜像提供的 proteinmpnn 启动脚本会先加载 DTK 环境,再调用 /opt/ProteinMPNN/protein_mpnn_run.py。辅助脚本通过 python 直接执行,因此本节仍显式加载 DTK。不要在现有厂商版 PyTorch 上直接覆盖安装普通 CUDA 版 PyTorch,否则可能破坏加速卡运行环境。
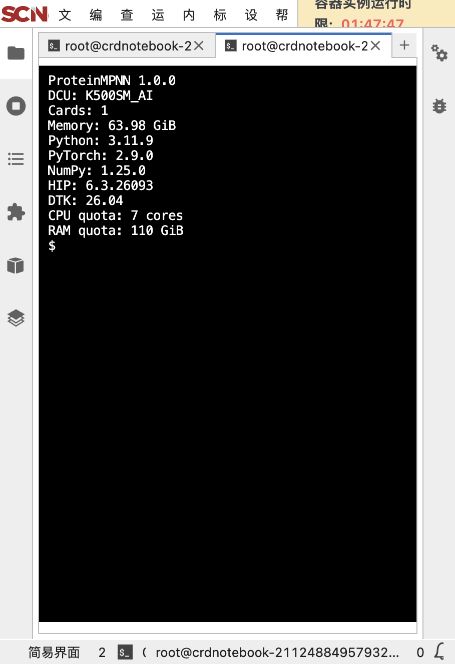
本次检查显示加速卡可用、设备数为 1。镜像中的程序增加了 --device 参数,可以显式选择 cuda。这里的 cuda 是 PyTorch 的设备接口名称,在本实例上实际对应国产加速卡及 HIP 后端。官方上游程序与此镜像的参数并非完全一致,应以镜像内的 --help 为准。
本文使用镜像内置的 5L33、6MRR 和 3HTN,分别演示单结构、批量和约束设计。算例来自官方仓库的 inputs 目录;已与上游提交 8907e6671bfbfc92303b5f79c4b5e6ce47cdef57 中的同名文件逐一核对 Git blob,三个输入均一致;校验记录随文附件提供。[2]
export MPNN=/opt/ProteinMPNN
export RUN_DIR=/root/private_data/proteinmpnn_practice
mkdir -p "$RUN_DIR"/{input/monomers,input/complex,results,logs}
cp "$MPNN/inputs/PDB_monomers/pdbs/5L33.pdb" "$RUN_DIR/input/monomers/"
cp "$MPNN/inputs/PDB_monomers/pdbs/6MRR.pdb" "$RUN_DIR/input/monomers/"
cp "$MPNN/inputs/PDB_complexes/pdbs/3HTN.pdb" "$RUN_DIR/input/complex/"
请使用一个新的 RUN_DIR,避免旧结果被覆盖或额外 PDB 混入批量输入。本文以 /root/private_data 为输出位置;平台说明该目录属于个人数据目录,不会打包进入分享镜像。正式保存数据前应确认当前实例的存储生命周期,并在试用时限结束前下载结果。[4]
在解析输入时,应检查链标识、缺失主链原子和残基编号。标准模型使用 N、CA、C、O 主链原子。本文中,5L33 与 6MRR 解析后分别为 106 和 68 个位置;PDB 的 ATOM 行数、CA 行数以及残基编号终点不一定等于模型序列长度,不能用它们替代解析结果。
对 5L33 生成 8 条候选序列,使用 v_48_020 权重、采样温度 0.1 和随机种子 37:
proteinmpnn \
  --pdb_path "$RUN_DIR/input/monomers/5L33.pdb" \
  --out_folder "$RUN_DIR/results/01_single" \
  --model_name v_48_020 \
  --num_seq_per_target 8 --batch_size 4 \
  --sampling_temp 0.1 --seed 37 --device cuda \
  --save_score 1 2>&1 | tee "$RUN_DIR/logs/01_single.log"
主要输出为 results/01_single/seqs/5L33.fa。该文件包含一条原始序列和 8 条生成序列,因此共有 9 条 FASTA 记录。开启 --save_score 1 后,scores 目录还会保存数值评分文件。原始序列用于参照,不计入生成序列数量。
本镜像以 num_seq_per_target 整除 batch_size 的商确定批次数。为了得到指定数量,请保证序列数是 batch_size 的整数倍;若前者小于后者,甚至可能没有生成序列。多温度采样会对每个温度生成相应数量的序列,统计结果时应同时考虑温度数。
批量模式先将输入目录内的 PDB 解析为 JSONL,再用一次命令处理全部结构。这能减少反复启动程序和加载模型的操作。
python "$MPNN/helper_scripts/parse_multiple_chains.py" \
  --input_path "$RUN_DIR/input/monomers" \
  --output_path "$RUN_DIR/input/monomers.jsonl"
proteinmpnn \
  --jsonl_path "$RUN_DIR/input/monomers.jsonl" \
  --out_folder "$RUN_DIR/results/02_batch" \
  --model_name v_48_020 \
  --num_seq_per_target 8 --batch_size 4 \
  --sampling_temp 0.1 --seed 37 --device cuda \
  --save_score 1 2>&1 | tee "$RUN_DIR/logs/02_batch.log"
results/02_batch/seqs 中应出现 5L33.fa 和 6MRR.fa,每个文件各含 8 条候选序列及一条原始序列。建议按输入名称核对文件数量,结合终端日志检查是否有结构因长度、非法字符或解析异常被丢弃。
多链设计需要同时说明哪些链参与设计、哪些位置必须保留。本例保留 3HTN 的三链结构作为条件,只设计 A 链,并固定 A 链解析序列的前 10 个位置;B、C 链保持原序列。该设置用于展示约束操作,不代表对该蛋白提出特定功能优化假设。
python "$MPNN/helper_scripts/parse_multiple_chains.py" \
  --input_path "$RUN_DIR/input/complex" \
  --output_path "$RUN_DIR/input/complex.jsonl"
python "$MPNN/helper_scripts/assign_fixed_chains.py" \
  --input_path "$RUN_DIR/input/complex.jsonl" \
  --output_path "$RUN_DIR/input/chains.jsonl" --chain_list A
python "$MPNN/helper_scripts/make_fixed_positions_dict.py" \
  --input_path "$RUN_DIR/input/complex.jsonl" \
  --output_path "$RUN_DIR/input/fixed.jsonl" \
  --chain_list A --position_list "1 2 3 4 5 6 7 8 9 10"
proteinmpnn \
  --jsonl_path "$RUN_DIR/input/complex.jsonl" \
  --chain_id_jsonl "$RUN_DIR/input/chains.jsonl" \
  --fixed_positions_jsonl "$RUN_DIR/input/fixed.jsonl" \
  --out_folder "$RUN_DIR/results/03_fixed" \
  --model_name v_48_020 \
  --num_seq_per_target 8 --batch_size 4 \
  --sampling_temp 0.1 --seed 37 --device cuda \
  --save_score 1 --save_probs 1 \
  2>&1 | tee "$RUN_DIR/logs/03_fixed.log"
assign_fixed_chains.py 的 --chain_list 填写的是需要设计的链。本例输入 A,意味着 A 链参与设计,其他链固定。make_fixed_positions_dict.py 中的 position_list 才指定设计链内部需要固定的位置。两者用途不同,不能仅根据脚本名称推断参数含义。
固定位点使用解析序列中的链内位置,从 1 开始,而非直接使用 PDB 残基编号。3HTN 的 A 链首残基 PDB 编号为 43,本例 position_list 中的 1 对应解析序列首位,不是 PDB 编号 1。含插入码、缺失残基的结构尤其需要先建立位置映射。[5]
输出 FASTA 通常只包含设计链;本例 3HTN.fa 的序列长度为 A 链的 143 个位置,不会输出全部 429 个结构位置。首条记录的头信息应显示 fixed_chains 为 B、C,designed_chains 为 A。--save_probs 1 保存了包含完整结构位置的采样数组,可进一步核对固定链。长链、大批量任务若不需要此类检查,可关闭概率输出以节省磁盘空间。
随文提供 run_examples.sh 和 qc_results.py。将两者上传至实例后,可直接运行完整流程并检查结果:
bash run_examples.sh /root/private_data/proteinmpnn_practice
python qc_results.py /root/private_data/proteinmpnn_practice
如果已按前文分步运行,可直接执行检查脚本,无需重复运行算例。检查脚本验证候选数量、序列长度、氨基酸字符和有限评分,同时逐条验证 A 链的前 10 个位置,并利用完整采样数组验证 B、C 固定链中有序列定义的位置。
| 模式 | 目标 | 设计序列长度 | 候选数 | 生成耗时 |
|---|---|---|---|---|
| 单结构 | 5L33 | 106 | 8 | 1.3575 秒 |
| 批量 | 5L33 | 106 | 8 | 1.3638 秒 |
| 批量 | 6MRR | 68 | 8 | 0.8613 秒 |
| 约束设计 | 3HTN | 143 | 8 | 4.9840 秒 |
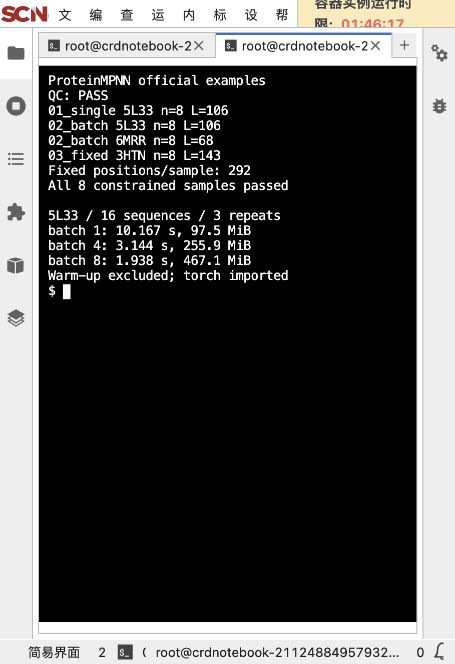
本次三个算例流程共生成 32 条候选序列,四个 FASTA 文件各有 8 条候选,数量、长度与有限评分检查全部通过。3HTN 每条候选的 292 个受检固定位置均与输入一致,其中包括 A 链前 10 位,以及 B、C 链中有序列定义的位置;B 链缺失主链的占位不作为已解析残基计数。每个目标文件内的 8 条候选均互不重复。单结构与批量模式中的 5L33 结果按各自流程计数,不代表 32 条跨文件独立序列。
表中的生成耗时来自 ProteinMPNN 自身打印的单目标计时,包含采样和相关评分及输出环节,不包含 Python 与 PyTorch 初次导入、全部程序启动时间或 Notebook 创建时间。3HTN 的计时长度为完整三链的 429 个位置,FASTA 仅输出被设计的 A 链。不同算例的长度和约束不同,不宜直接用这些数值推算其他蛋白的耗时。
为比较 batch_size 的影响,另用 5L33 生成每次 16 条序列,在同一 Python 解释器中预热一次后,对 batch_size 为 1、4、8 各运行三次。计时前后同步设备,时间覆盖模型加载与主函数执行,但不包含 Python 与 PyTorch 的初次导入。各轮顺序为 1、4、8;表中给出三次耗时中位数及其范围。
| batch_size | 耗时中位数 | 三次范围 | PyTorch 已分配显存峰值 |
|---|---|---|---|
| 1 | 10.167 秒 | 10.017 至 10.664 秒 | 97.5 MiB |
| 4 | 3.144 秒 | 3.097 至 3.249 秒 | 255.9 MiB |
| 8 | 1.938 秒 | 1.903 至 1.943 秒 | 467.1 MiB |
该短链算例中,batch_size 为 8 的中位耗时约为 batch_size 为 1 的 1/5.25。增加批量可减少采样批次数,但同时提高显存占用,不能据此认定所有蛋白均应使用同一批量。表中显存是 PyTorch 张量的已分配显存峰值,不含设备上下文和其他运行库开销,不代表进程总显存或最低显存需求。完整原始记录见附件 metadata/benchmark.json。
FASTA 头信息中的 score 是设计区域的平均负对数概率,global_score 对应完整结构的有效位置。分值越低表示模型对该序列的支持程度越高;比较候选时应保持骨架、权重和约束设置一致。seq_recovery 反映设计区域与输入原序列的一致比例,不是实验成功率。ProteinMPNN 的评分不等于结合自由能,也不能证明序列一定正确折叠或具有目标功能。后续应结合结构预测和实验验证。[2]
导入 PyTorch 时找不到动态库,通常应先检查是否加载 /opt/dtk-26.04/env.sh,并优先使用镜像提供的 proteinmpnn 命令。若程序在 CPU 上运行,应检查 torch.cuda.is_available() 与实例的卡资源;本镜像可用 --device cuda 明确要求加速设备,避免无意中采用 CPU。
候选数少于预期时,先检查 num_seq_per_target 能否被 batch_size 整除,再检查温度数量及输入是否被跳过。显存不足时降低 batch_size,保留输入、参数和日志后再试,不需要先重建整个环境。
发现不该变化的残基发生突变时,应核对设计链配置、fixed_positions_jsonl 以及 PDB 编号到解析位置的映射。只查看 FASTA 中未出现固定链,不能据此判断固定链丢失;应结合首条头信息和完整采样数组检查。
正式任务请记录镜像版本、输入文件、权重和源码校验值、采样温度、随机种子与输出。固定种子有助于追溯同一环境下的结果,但不同硬件、软件版本和批量设置仍可能影响随机数使用顺序与输出,不能据此承诺跨环境逐字符一致。
本地保留的构建文件以厂商基础镜像 jupyterlab-pytorch:2.9.0-ubuntu22.04-dtk26.04-py3.11-devel 为基础,将 ProteinMPNN 源码和模型权重放入 /opt/ProteinMPNN,提供 JupyterLab、SSH 相关组件及命令行启动封装。构建文件的基础镜像地址如下:
image.sourcefind.cn:5000/dcu/admin/base/jupyterlab-pytorch:2.9.0-ubuntu22.04-dtk26.04-py3.11-devel适配的关键在于保留厂商 PyTorch 与 DTK 的版本组合,并在加载 PyTorch 前初始化运行库环境。启动封装的核心逻辑如下:
#!/usr/bin/env bash
set -e
set +u
source /opt/dtk-26.04/env.sh
set -u
exec python /opt/ProteinMPNN/protein_mpnn_run.py "$@"
本镜像的运行程序还增加了显式设备选择,故不同于上游未修改版本。镜像内没有可用的 Git 提交信息,FASTA 头部可能显示 git_hash=unknown;随文提供源码与权重 SHA256 作为本次复现依据。上游来源版本仅用于核对公开输入,不能替代镜像修改版代码的版本标识。
分享镜像时,程序与权重应放在能被保存进镜像的系统目录内,不能仅保存在 /root/private_data 中。构建完成后应从新实例验证帮助命令、设备识别、权重加载和真实 PDB 推理。ProteinMPNN 的命令行推理无需配置额外 Web API 服务。[4]
[1] Dauparas J 等 2022 Robust deep learning based protein sequence design using ProteinMPNN Science 378 49–56 DOI 10.1126/science.add2187。https://doi.org/10.1126/science.add2187
[2] ProteinMPNN 官方仓库与使用说明。https://github.com/dauparas/ProteinMPNN
[3] 超算互联网 Notebook 快速使用。https://www.scnet.cn/help/docs/mainsite/ai/notebook/quick-use/
[4] 超算互联网镜像制作与使用实践,含个人数据目录与镜像保存说明。https://www.scnet.cn/help/docs/mainsite/ai/practice/development/opencode/index.html
[5] ProteinMPNN 官方固定残基设计示例。https://github.com/dauparas/ProteinMPNN/blob/main/examples/submit_example_4.sh