高性能计算服务
>
软件专区
>
最佳实践
>
让大脑控制电脑:基于脑电图的运动意图离线解码与跨被试泛化实践
脑机接口把脑电活动转换成控制信号。运动想象任务提供了一条清晰的入门路径:受试者想象双手或双脚运动,脑电图(EEG)节律随任务条件变化,分类器根据这些变化判断意图。公开数据允许我们先把读取、分段、训练和评估跑通,再考虑实时设备。
本文使用 PhysioNet 的 EEG Motor Movement/Imagery Dataset(EEGMMIDB),选取 10 名受试者的双手与双脚运动想象记录,建立 CPU 可运行的 CSP+LDA 基线。我们按三步检查:先留出同一受试者的一次新运行,测试两类想象能否分开;再留出一名陌生受试者,观察分数保留多少;最后打乱训练标签,确认结果是否回到机会水平。
实践目标如下:
•用脚本完成 EDF 读取、通道标准化、滤波、事件分段和特征提取。
•用 4 分量 CSP 和 LDA 构成低成本二分类管线。
•用被试内留一运行、跨被试留一受试者和随机标签对照,分别观察新运行表现、跨个体迁移和经验机会水平。
•记录环境版本、随机种子、计算时间、输出路径和校验结果,让每个汇总值都能回到 CSV、JSON 或运行日志。
先记录三项基线读数。平衡准确率(Balanced Accuracy,BA)的被试内 30 个折级等权平均为 0.6946,跨被试 10 个留出受试者折的等权平均为 0.5663,50 次随机标签重复的均值为 0.5031。被试内到跨被试的平均差值为 0.1283。这些数字只描述本文 10 名受试者和三类评估设计。
EEGMMIDB 由 PhysioNet 提供,原始记录以 EDF 文件保存。本文固定使用受试者 S001–S010 的运行 6、10、14,共 30 个 EDF。每个文件包含 T1、T2 两类事件:脚本把 T1 编码为双手想象,把 T2 编码为双脚想象,再把标签转换为 0/1。
脚本按文件列表顺序写入 run_index。在固定文件顺序中,run_index=0/1/2 分别对应原始运行 6/10/14;这个字段服务于被试内留组,任务标签仍然来自 T1/T2。每名受试者贡献 45 个有效 epoch,10 人共 450 个。每个 epoch 含 64 个 EEG 通道和 161 个采样点,分析窗口为提示后 1.0–2.0 秒。两类计数随受试者变化,单人每类约 21–24 个,整体接近平衡。
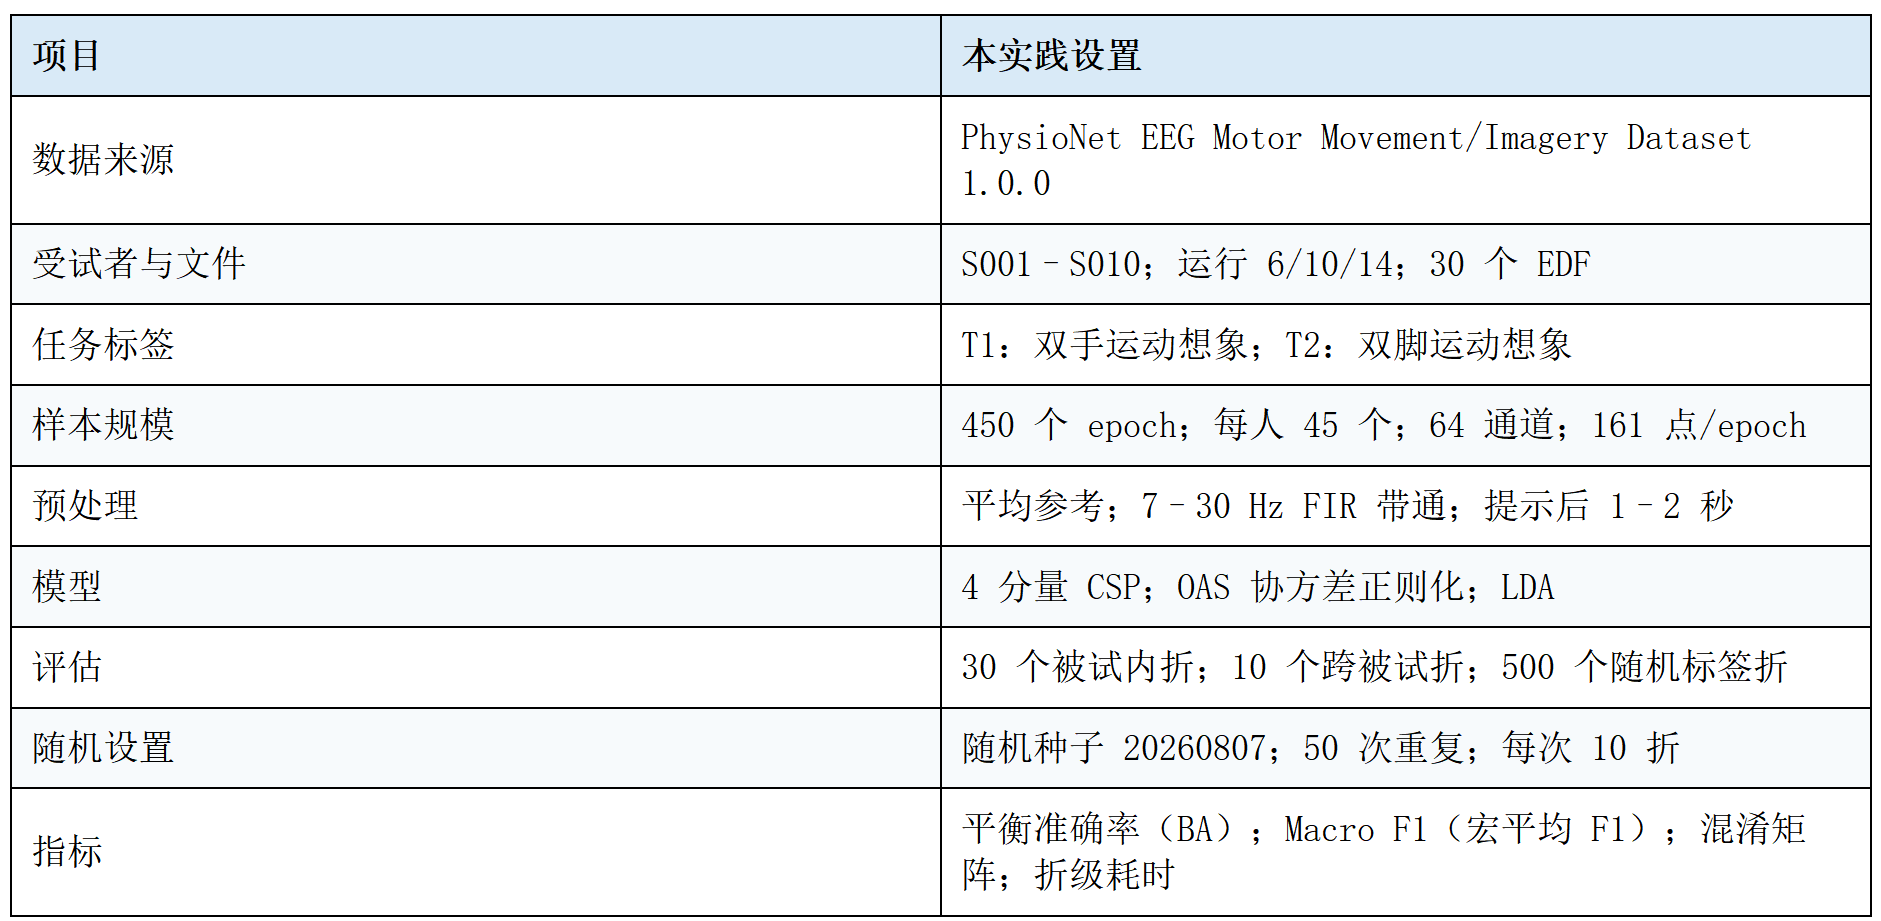
inputs/manifest.json 保存每个 EDF 的大小和 SHA-256,用于核对文件完整性。运行摘要的 load_summary 汇总每名受试者的 epoch、通道和时间点;逐 EDF 的事件数与拒绝 epoch 明细尚未登记,正文保持这个证据边界。
案例目录把输入、方案、运行、记录、脚本和写作材料分开保存:inputs/ 放 EDF 与清单,plan/ 放范围和批准记录,runs/ 放每次运行的输出,records/ 放时间线与产物哈希,scripts/ 放实验和绘图脚本,writing/ 放正文及版本链。目录分开后,运行结果可以直接成为下一步分析的输入。
本次实践在 SCNet 指定 Linux 主机上做 CPU 离线计算。版本为 Python 3.10.12、MNE 1.10.2、scikit-learn 1.5.2、NumPy 1.26.4、SciPy 1.14.1、pandas 2.2.3 和 Matplotlib 3.9.2。主机探测到 32 个 CPU 核心、约 504 GiB 总内存、约 419 GiB 可用内存和约 991 GiB 可用磁盘。
依赖先在本地准备 Linux wheels,再上传到案例目录并解包到 site-packages。远程命令设置 PYTHONPATH=site-packages,让离线主机直接加载这组依赖。正式十人任务的有效线程控制来自 OPENBLAS_NUM_THREADS、OMP_NUM_THREADS、MKL_NUM_THREADS 和 NUMEXPR_NUM_THREADS;pilot.py 的 --n-jobs 参数会被解析。
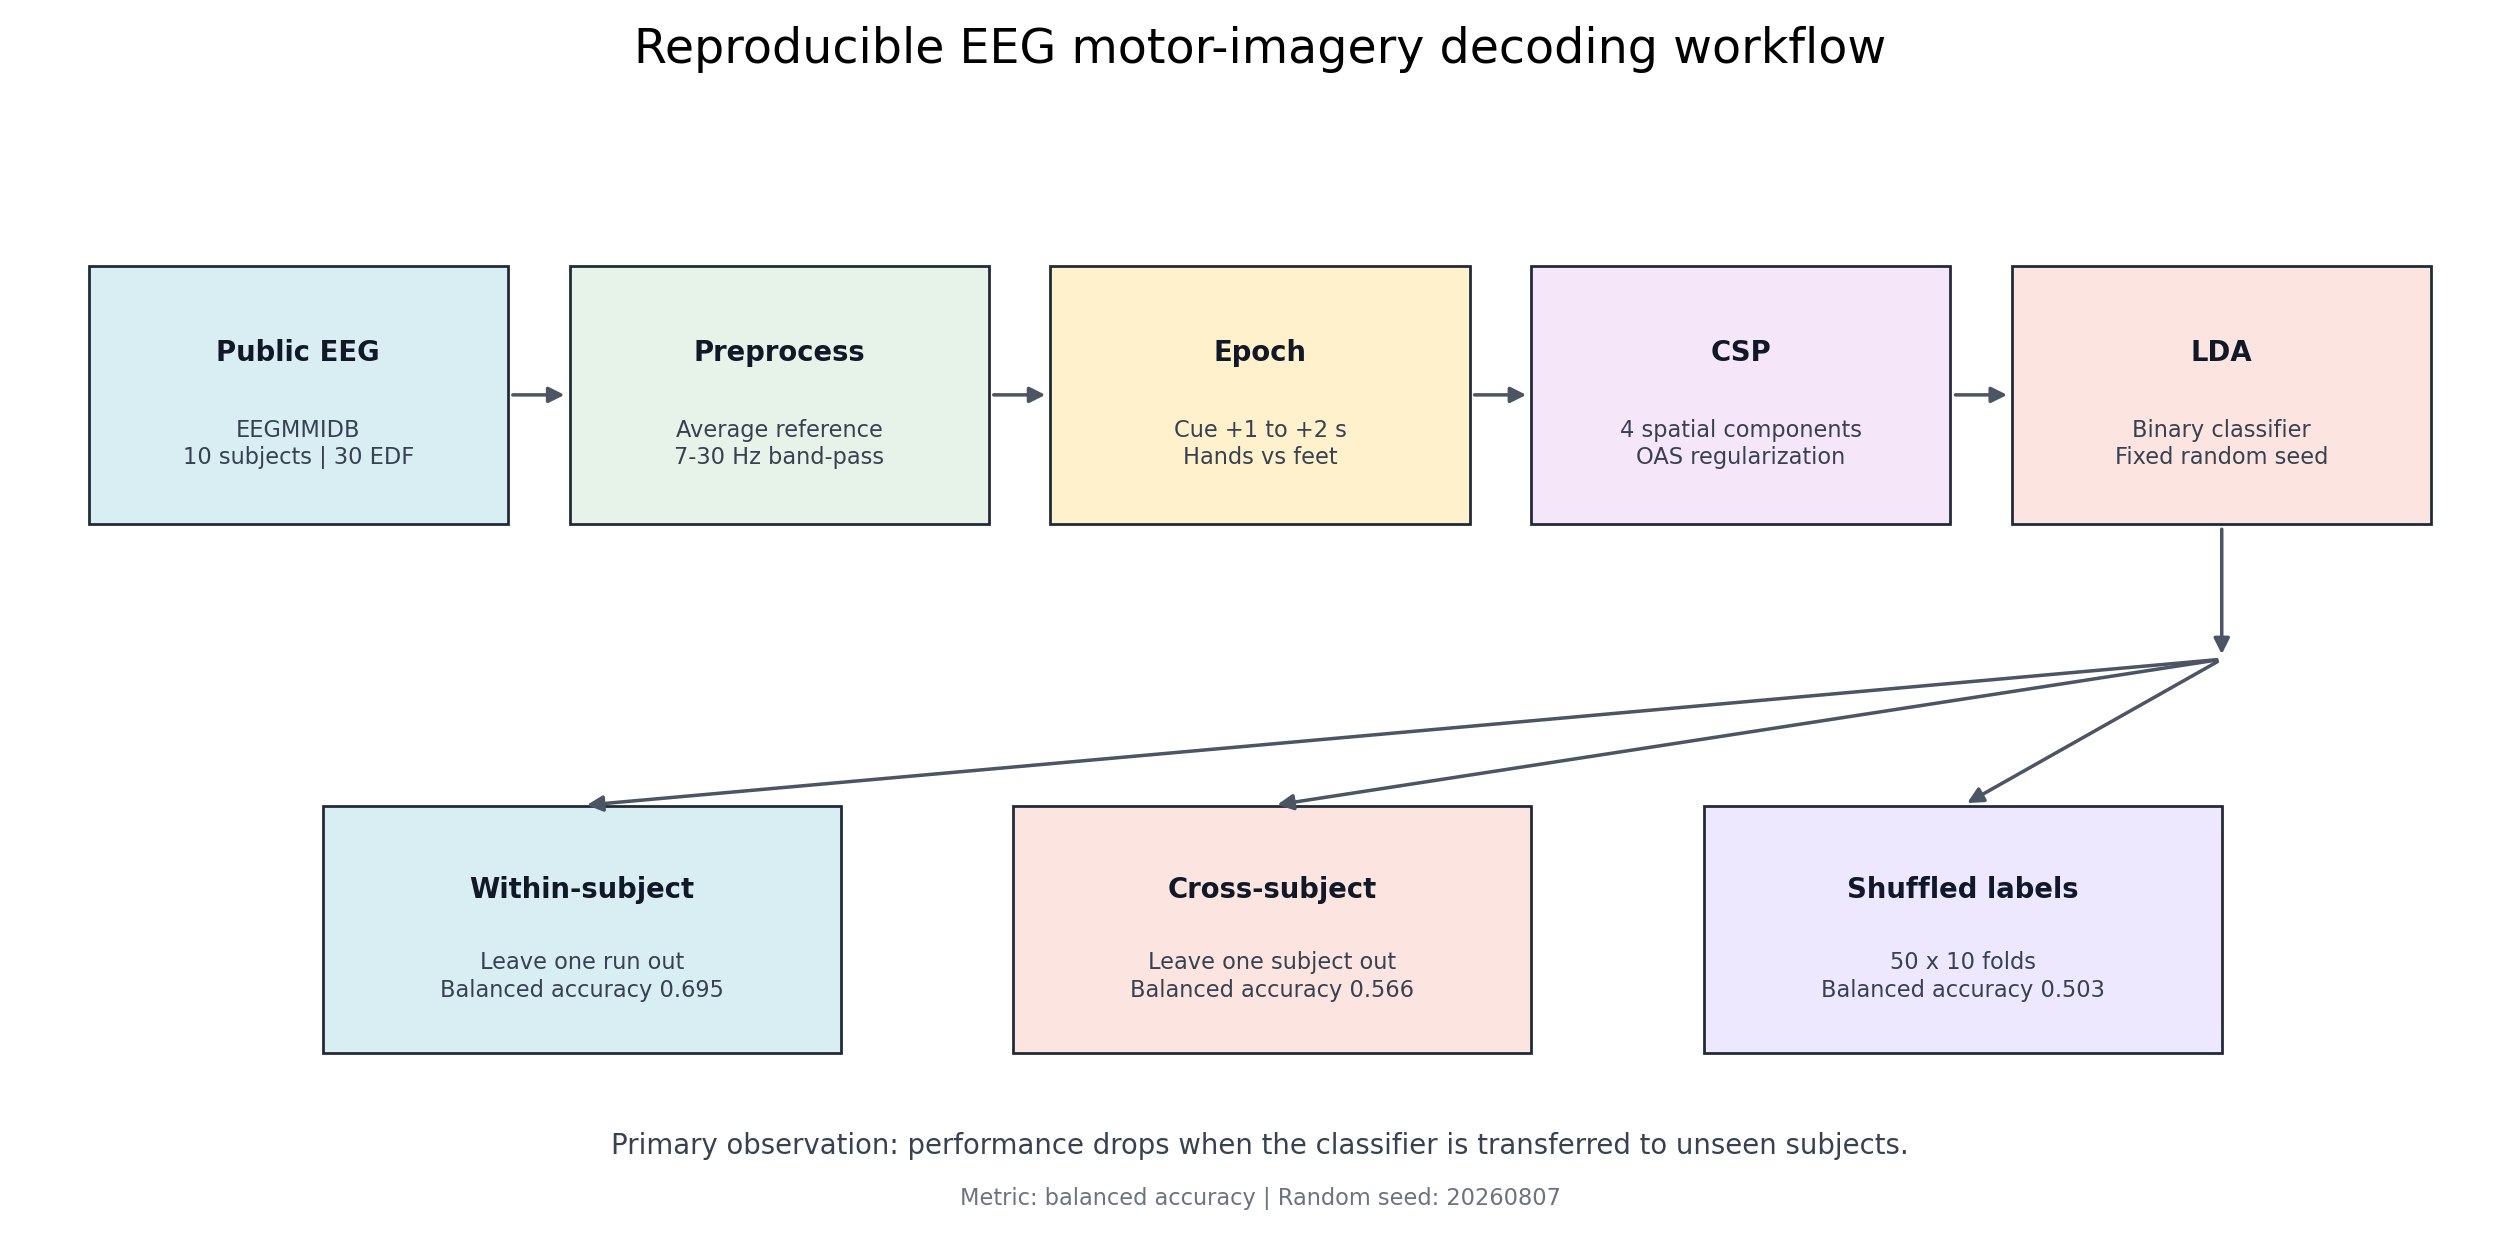
整条流程由输入、预处理、分段、特征、分类和三条评估路径组成。先看整体路径,再进入每个节点:
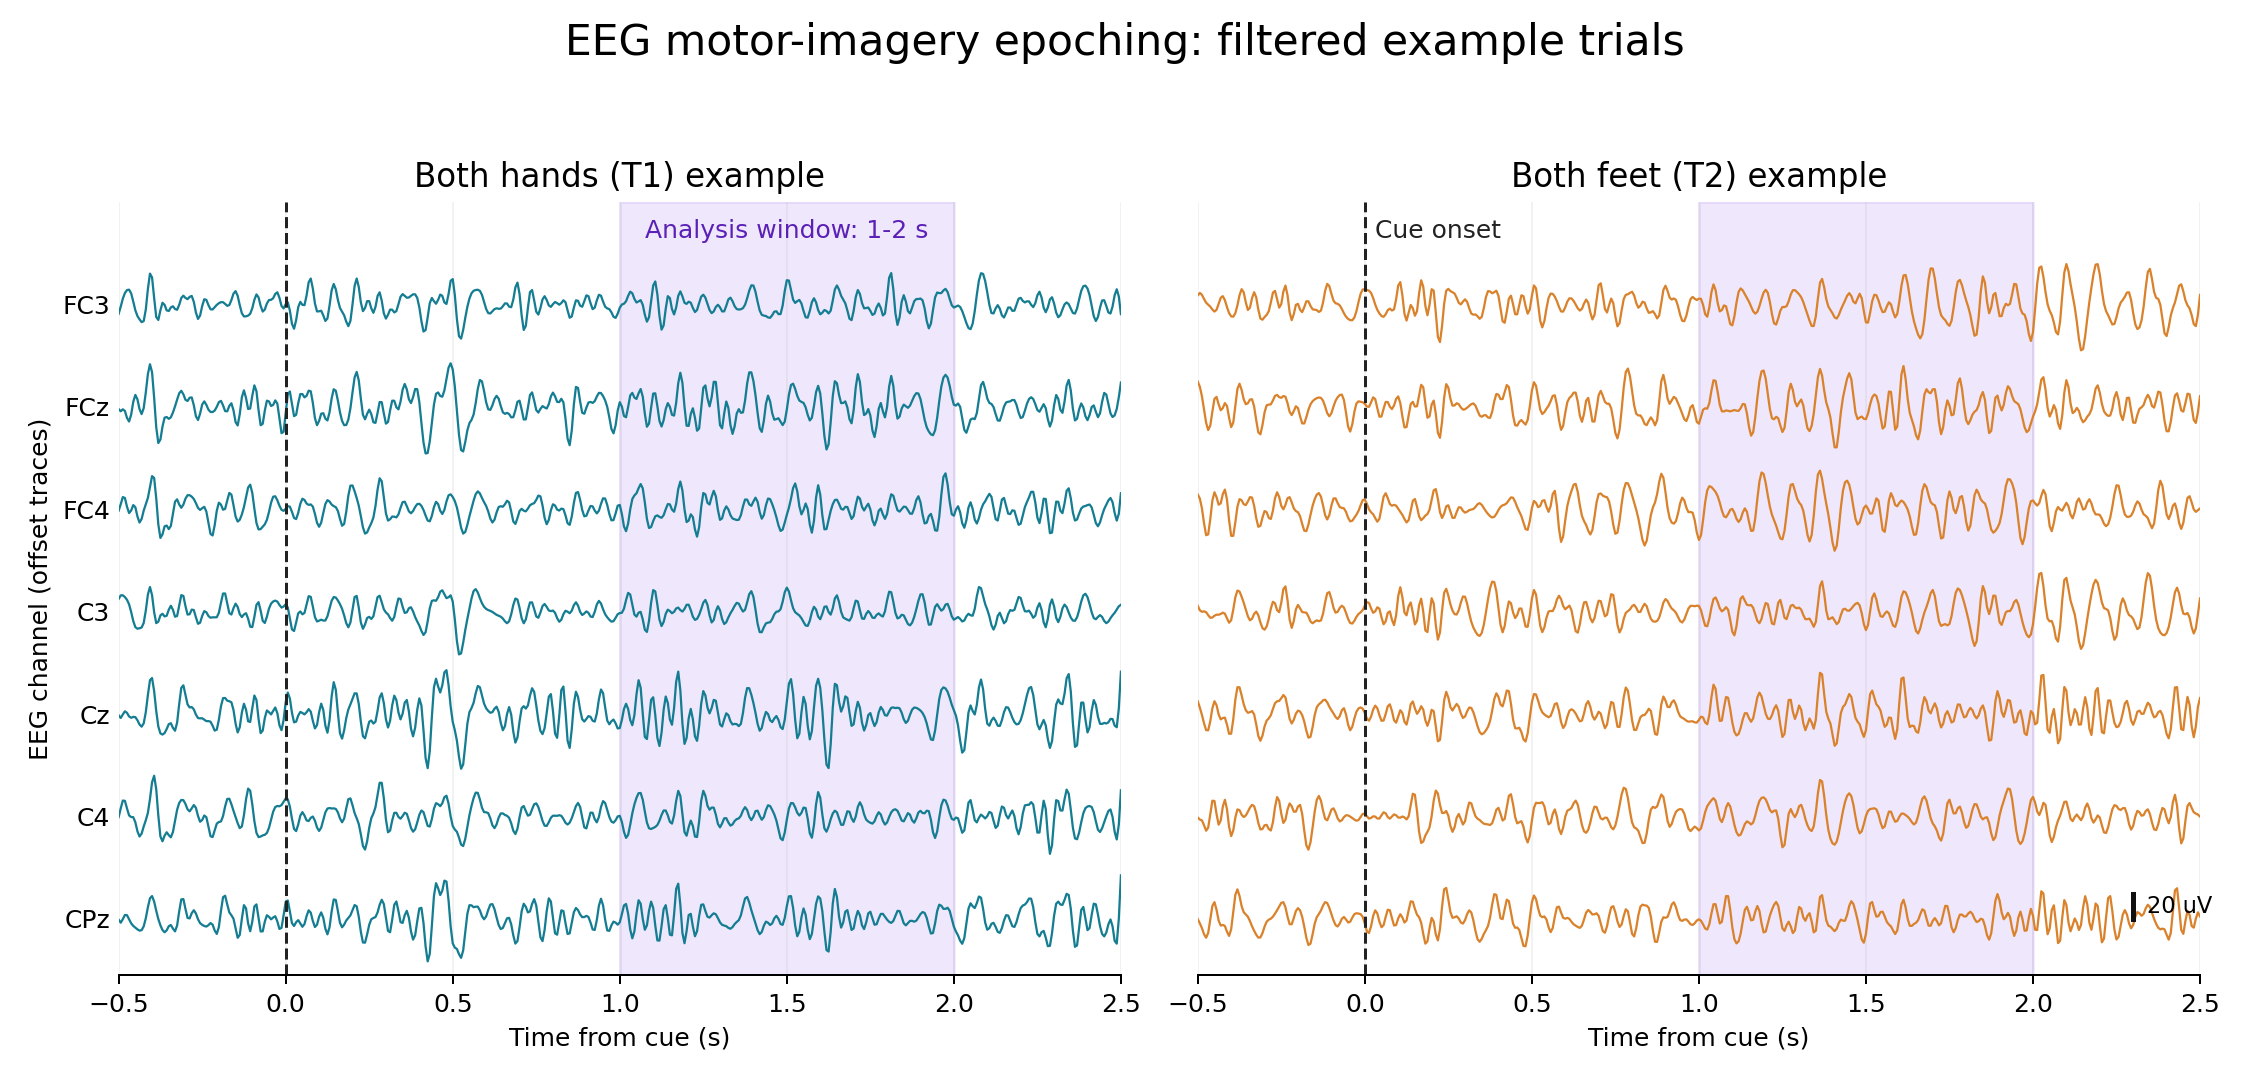
接着核对事件时刻和分析窗口是否一致。
脚本对每个 EDF 执行同一组动作:读取并标准化通道名,设置 standard_1005 电极位置,做平均参考和 7–30 Hz FIR 带通滤波,从注释中提取 T1/T2,最后截取提示后 1–2 秒的 epoch。基线校正关闭,带有拒绝标记的片段交给 MNE 排除。
下面片段保留影响数据边界的核心逻辑。subjects 和 data_root 由命令行参数传入;函数返回的数据、标签与运行编号会登记到 subject_runs:
import mne
import numpy as np

def load_subject(subject, data_root):
    file_paths = mne.datasets.eegbci.load_data(
        subjects=[subject], runs=[6, 10, 14],
        path=str(data_root), update_path=False, verbose="ERROR",
    )
    epochs_by_run, labels_by_run, groups_by_run = [], [], []
    for run_index, file_path in enumerate(file_paths):
        raw = mne.io.read_raw_edf(file_path, preload=True, verbose="ERROR")
        mne.datasets.eegbci.standardize(raw)
        raw.set_montage("standard_1005", on_missing="ignore", verbose="ERROR")
        raw.set_eeg_reference("average", projection=False, verbose="ERROR")
        raw.filter(7.0, 30.0, fir_design="firwin",
                   skip_by_annotation="edge", verbose="ERROR")

        events, event_id = mne.events_from_annotations(
            raw, event_id={"T1": 2, "T2": 3}, verbose="ERROR"
        )
        events = events[np.isin(events[:, 2], list(event_id.values()))]
        epochs = mne.Epochs(
            raw, events, event_id=event_id, tmin=1.0, tmax=2.0,
            baseline=None, preload=True, reject_by_annotation=True,
            verbose="ERROR"
        )
        data = epochs.get_data(copy=True)
        labels = (epochs.events[:, -1] == event_id["T2"]).astype(int)
        epochs_by_run.append(data)
        labels_by_run.append(labels)
        groups_by_run.append(np.full(labels.size, run_index, dtype=int))

    return (
        np.concatenate(epochs_by_run),
        np.concatenate(labels_by_run),
        np.concatenate(groups_by_run),
    )

subject_runs = {
    subject: load_subject(subject, data_root) for subject in subjects
}
subject_data = {
    subject: (data, labels)
    for subject, (data, labels, _) in subject_runs.items()
}
每个 data 都是 epoch × channel × time 数组,单个 epoch 的形状为 64 × 161。labels 把 T1/T2 映射为 0/1,run_groups 只用于被试内留组;subject_data 去掉运行编号后供跨被试和随机标签路径复用。
为核对事件与窗口,下面从每类抽取 1 个 epoch。S001 运行 6 共检测到 T1=7、T2=8 个事件;全体 450 个 epoch 的汇总来自 load_summary。
窗口核对完成后,脚本把同一规则应用到全部事件,再进入 CSP 拟合。
CSP(Common Spatial Pattern)在两类条件之间寻找空间滤波器,让滤波后分量的方差形成最大反差。这里保留 4 个分量,使用 OAS 正则化估计协方差,再对每个分量取对数方差。这样可以把 64 通道输入压到少量特征,参数规模适合 CPU 基线。
LDA 在这些特征上建立线性决策边界。CSP 负责空间特征,LDA 负责分类。三条评估路径复用同一管线;每个评估折都会重新调用 build_model() 并独立 fit:
from mne.decoding import CSP
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.pipeline import make_pipeline

def build_model():
    return make_pipeline(
        CSP(n_components=4, log=True, norm_trace=False, reg="oas"),
        LinearDiscriminantAnalysis(),
    )
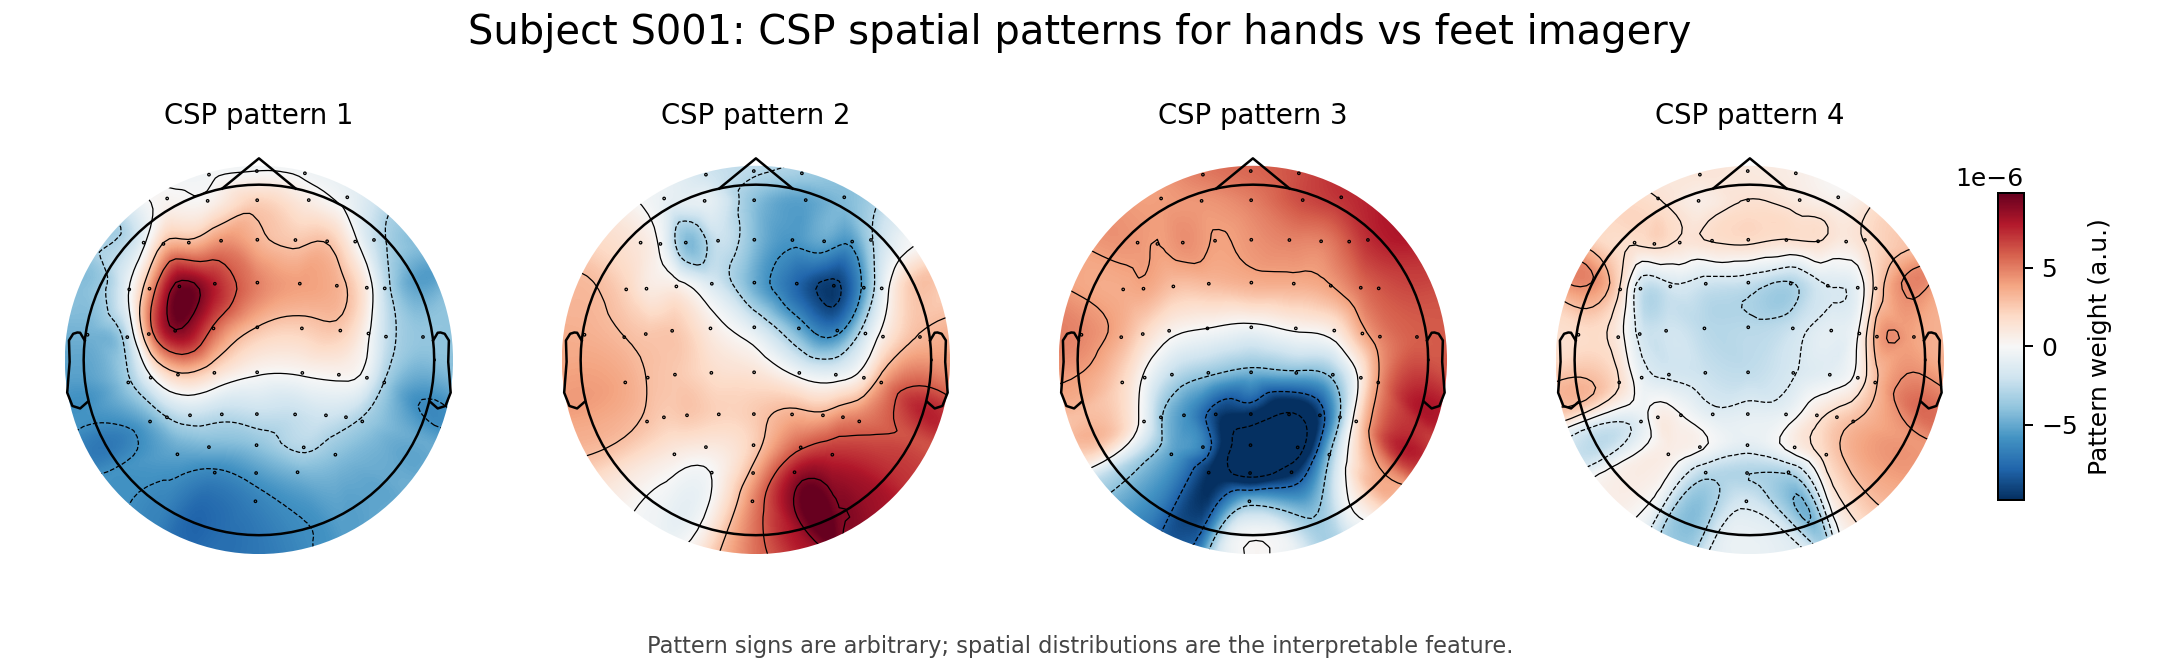
测试 epoch 只在预测阶段进入模型,本折 CSP 和 LDA 只读取训练数据。CSP 图展示通道组合,红蓝符号允许整体翻转;脑源定位需要独立的源成像分析。
下面的模式图用于解释特征空间。它把 S001 运行 6、10、14 的 45 个 epoch 合并后做一次独立的全样本拟合。
三条路径先固定同一套预处理和模型参数,再改变留组单位或训练标签。共同指标是平衡准确率(Balanced Accuracy,BA):
BA = (TPR + TNR) / 2
它分别计算双手和双脚的召回率,再取平均;轻微类别不平衡不会直接改变单一多数类的权重。Macro F1 作为补充指标,混淆矩阵保留类别级错误。
被试内留一运行。 对每名受试者留下一个完整运行作测试,另外两个运行作训练。每折测试 15 个 epoch,10 名受试者共 30 折。run_index 只决定留组,T1/T2 仍是分类目标。
跨被试留一受试者。 每折留下一个完整受试者,训练集含其余 9 人的 405 个 epoch,测试集含被留出受试者的 45 个 epoch。这个分组直接测试模型面对陌生个体时的迁移表现。
随机标签对照。 沿用跨被试的十折索引和全部预处理,只在每折训练前置换训练标签。重复 50 次,共得到 500 个对照折。对照均值提供当前流程的经验机会水平参照。
下面的评估折片段把留组边界和指标计算放在同一处。split_subject() 合并 9 名训练受试者,外层循环再补充 subject、折编号和耗时字段:
from sklearn.metrics import balanced_accuracy_score, confusion_matrix, f1_score

def split_subject(subject_data, held_out_subject):
    train_subjects = [s for s in subject_data if s != held_out_subject]
    train_data = np.concatenate([subject_data[s][0] for s in train_subjects])
    train_labels = np.concatenate([subject_data[s][1] for s in train_subjects])
    test_data, test_labels = subject_data[held_out_subject]
    return train_data, train_labels, test_data, test_labels

def score_fold(train_data, train_labels, test_data, test_labels):
    model = build_model()
    model.fit(train_data, train_labels)
    predicted = model.predict(test_data)
    return {
        "balanced_accuracy": float(
            balanced_accuracy_score(test_labels, predicted)
        ),
        "macro_f1": float(f1_score(test_labels, predicted, average="macro")),
        "confusion_matrix": confusion_matrix(test_labels, predicted).tolist(),
    }

within_rows = []
for subject, (data, labels, run_groups) in subject_runs.items():
    for held_out_run in np.unique(run_groups):
        train = run_groups != held_out_run
        within_rows.append({
            "subject": int(subject),
            "held_out_run": int(held_out_run),
            **score_fold(
                data[train], labels[train], data[~train], labels[~train]
            ),
        })

cross_rows = [
    {
        "held_out_subject": int(held_out_subject),
        **score_fold(*split_subject(subject_data, held_out_subject)),
    }
    for held_out_subject in sorted(subject_data)
]
within_rows 包含 10 名受试者各 3 个留一运行折,cross_rows 包含 10 个留一受试者折。掩码和受试者列表决定训练/测试边界,指标函数只读取当前测试集的真实标签与预测标签。
随机标签对照沿用同一折分,只替换训练标签。测试标签保持原始顺序,重复均值和经验 p 值可以由下面的短循环直接复算:
rng = np.random.default_rng(20260807)
shuffled_rows = []
for repeat in range(50):
    for held_out_subject in sorted(subject_data):
        train_data, train_labels, test_data, test_labels = split_subject(
            subject_data, held_out_subject
        )
        model = build_model()
        model.fit(train_data, rng.permutation(train_labels))
        predicted = model.predict(test_data)
        shuffled_rows.append({
            "repeat": repeat,
            "held_out_subject": int(held_out_subject),
            "balanced_accuracy": float(
                balanced_accuracy_score(test_labels, predicted)
            ),
        })

repeat_means = np.array([
    np.mean([
        row["balanced_accuracy"]
        for row in shuffled_rows if row["repeat"] == repeat
    ])
    for repeat in range(50)
])

observed = 0.5663243459
k = int(np.sum(repeat_means >= observed))
p_value = (1 + k) / (1 + len(repeat_means))
循环生成 500 条 shuffled_rows,每条都带有 repeat、held_out_subject 和 BA;同一重复的 10 个留出受试者分数再聚合为一个均值。本次 len(repeat_means)=50、k=1,因此经验单侧 p=0.0392。绘图脚本读取同一 CSV 的折级结果,按 repeat 聚合后生成图 5。
所有随机操作固定为 20260807。主计算先把三条路径写入远端统一结果根目录;归档时再分别放入本地 run-003-within-subject、run-004-cross-subject 和 run-005-shuffled-label-control。
远程主机采用离线依赖目录。提交前再次核对 30 个 EDF、site-packages、脚本和远端结果根目录;结果归档后再检查三个本地评估目录。这个动作只确认运行入口,实验参数已经在第 4 节固定。
实际命令如下。环境变量负责线程上限,--n-jobs 8 保留在命令中用于记录批准的资源参数:
env PYTHONPATH=site-packages \
  OPENBLAS_NUM_THREADS=8 OMP_NUM_THREADS=8 \
  MKL_NUM_THREADS=8 NUMEXPR_NUM_THREADS=8 \
  python3 scripts/pilot.py \
  --data-root data \
  --output-root results/full-subjects-001-010-20260807 \
  --subjects 1 2 3 4 5 6 7 8 9 10 \
  --n-jobs 8 \
  --shuffle-repeats 50 \
  --random-seed 20260807
命令读取 30 个 EDF,先完成被试内折分,再完成跨被试折分和随机标签对照。远程 results/full-subjects-001-010-20260807/ 会写入指标 CSV、pilot_summary.json、标准输出和错误日志。计算完成后,再按评估路径归档到本地的 run-003-within-subject、run-004-cross-subject 和 run-005-shuffled-label-control。
主计算完成后先运行 plot_pilot.py。它从 pilot_summary.json 计算被试级读数、性能比较图和聚合混淆矩阵,并写出 pilot_readout.json。随后 plot_case_figures.py 读取这个精简读数,生成流程图、事件窗口图和 CSP 模式图。远程图表完成后归档到本地 run-004 与 run-006;最后在固定工作区用 plot_shuffled_control.py 从归档 CSV 派生图 5。
远程绘图按以下顺序执行。第二条命令依赖第一条产生的 pilot_readout.json:
env PYTHONPATH=site-packages python3 scripts/plot_pilot.py \
  --summary results/full-subjects-001-010-20260807/pilot_summary.json \
  --output-root results/full-subjects-001-010-20260807

env PYTHONPATH=site-packages MPLCONFIGDIR=.matplotlib \
  python3 scripts/plot_case_figures.py \
  --data-root data \
  --readout results/full-subjects-001-010-20260807/pilot_readout.json \
  --output-root results/neuroscience-figures-20260807 \
  --subject 1 --event-run 6
远程图表归档后,回到固定工作区的案例根目录,使用带 NumPy 和 Matplotlib 的本地 Python 派生图 5:
python scripts/plot_shuffled_control.py \
  --metrics runs/run-005-shuffled-label-control/outputs/shuffled_control_metrics.csv \
  --summary runs/run-005-shuffled-label-control/outputs/shuffled_control_summary.json \
  --observed 0.5663243459 \
  --output runs/run-006-neuroscience-figures/outputs/shuffled_control_distribution.png \
  --summary-output runs/run-006-neuroscience-figures/outputs/shuffled_control_figure_summary.json
命令保留输入、输出和图号相关参数,绘图样式留在脚本中。
shuffled_control_summary.json 是 run-005 已归档的重复摘要,记录精确的观察值、分位数和经验 p 值。上一节的短循环给出这些字段的计算判据,绘图命令直接复用归档摘要。
六张图完成后,把脚本、PNG、派生摘要和图注文件登记 SHA-256;正文里的每条图注都回指相应输出路径。
命令结束后先查看远端结果根目录,再查看归档后的三个本地评估目录和 stderr.log。
主脚本把完整混淆矩阵留在 JSON,把便于汇总的折级指标写入 CSV:
import json

import pandas as pd

summary = {
    "subjects": sorted(subject_data),
    "within_subject": within_rows,
    "cross_subject": cross_rows,
    "shuffled_control": shuffled_rows,
    "random_seed": 20260807,
}
(args.output_root / "pilot_summary.json").write_text(
    json.dumps(summary, ensure_ascii=True, indent=2), encoding="utf-8"
)
pd.DataFrame(within_rows).drop(columns=["confusion_matrix"]).to_csv(
    args.output_root / "within_subject_metrics.csv", index=False
)
cross_frame = pd.DataFrame(cross_rows).drop(columns=["confusion_matrix"], errors="ignore")
cross_frame.to_csv(args.output_root / "cross_subject_metrics.csv", index=False)
pd.DataFrame(shuffled_rows).to_csv(
    args.output_root / "shuffled_control_metrics.csv", index=False
)
因此,正文中的表格可以从 CSV 重算,类别级错误可以回到 JSON 的混淆矩阵字段。
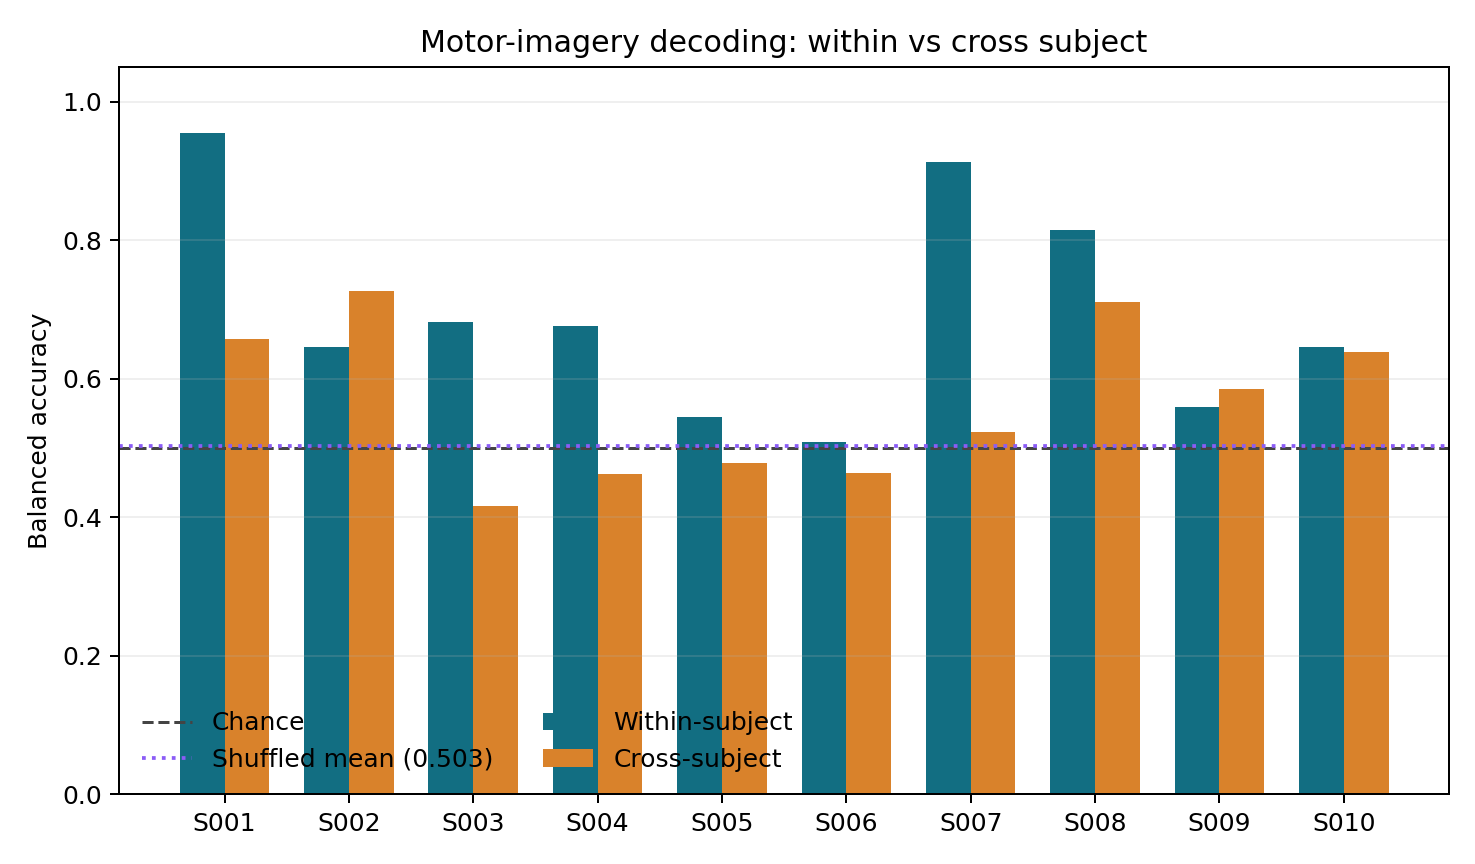
先看两个留组单位的平均分数。30 个被试内折的 BA 等权平均为 0.6946;10 个跨被试折的 BA 等权平均为 0.5663。平均 gap 为 0.1283。10 名受试者的被试级均值全部高于 0.5,跨被试有 6 名高于 0.5。这里的“被试级均值”指每位受试者的三折被试内平均与一个跨被试折的结果;单个折级结果仍可能低于 0.5。
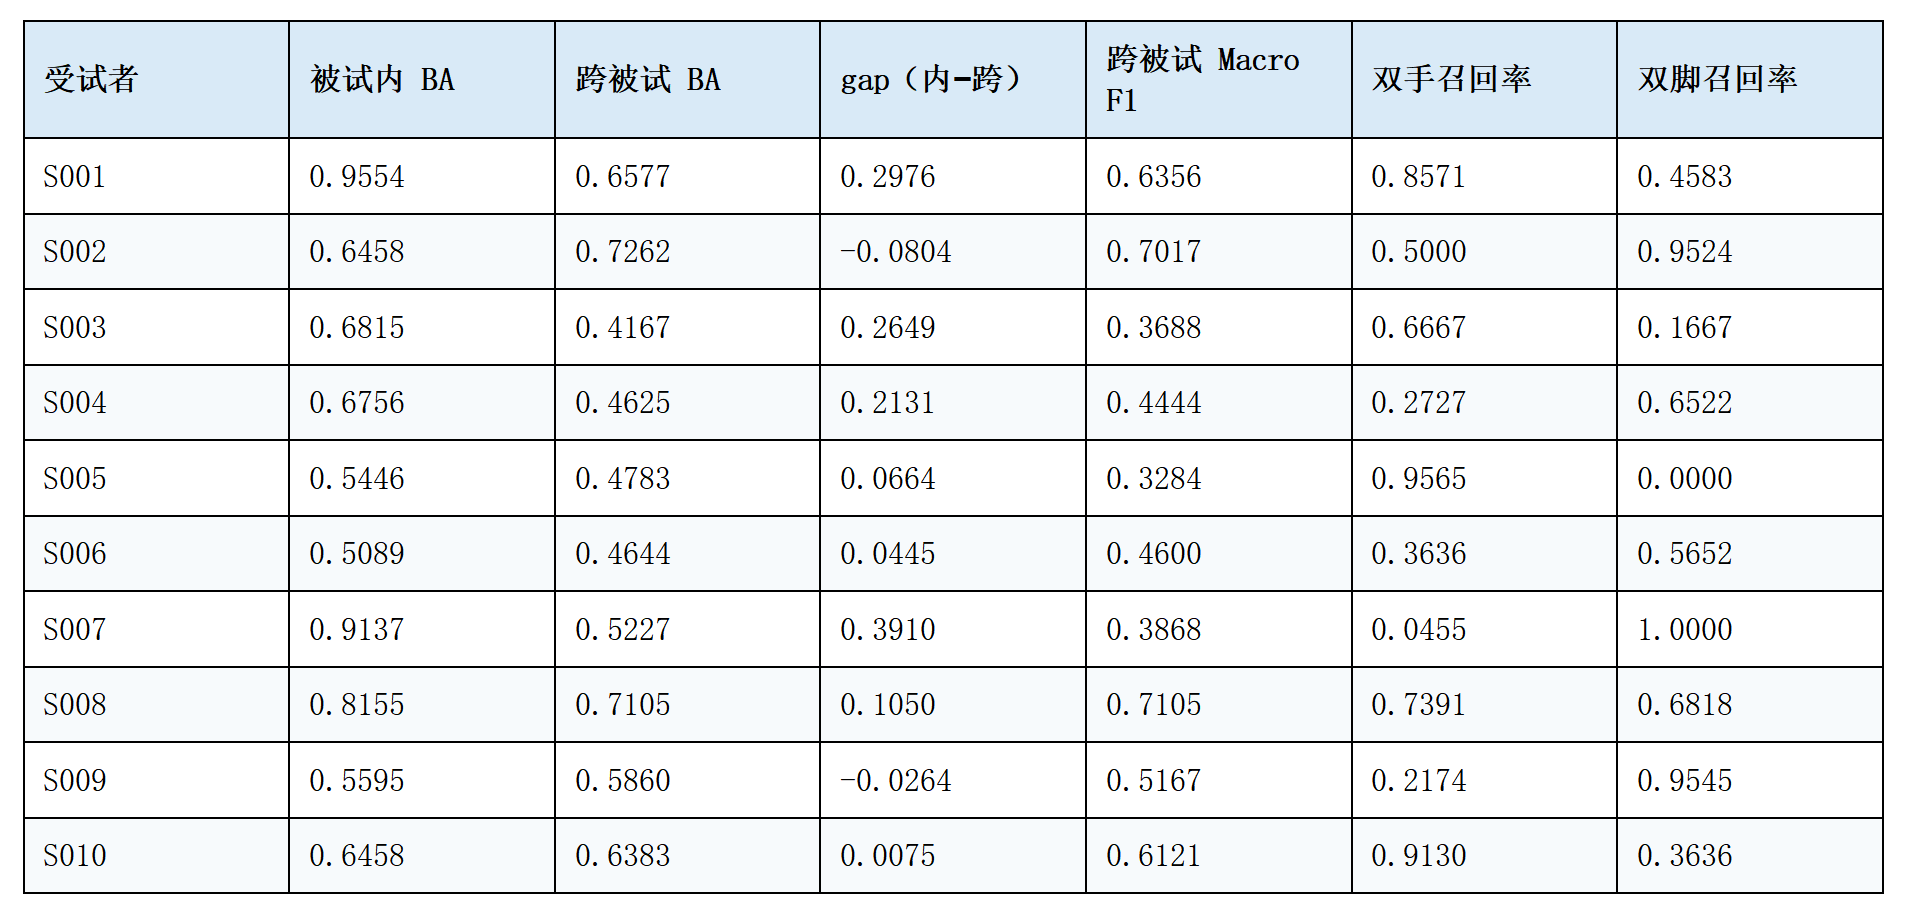
表中 gap 定义为被试内 BA 减去跨被试 BA。跨被试召回率取自每个留出受试者的 2×2 混淆矩阵,行顺序为双手、双脚。S001、S007 的迁移回落较大;S002、S009 的 gap 为负,跨被试分数高于各自的被试内三折均值。个体方向因此需要逐人查看,平均值无法代表每名受试者。
下面查看受试者级变化:
平均值需要和折级离散程度一起看。下表直接从 pilot_summary.json 的 30 个被试内折和 10 个跨被试折计算;每一行使用等权折平均,样本量也在表中列出。
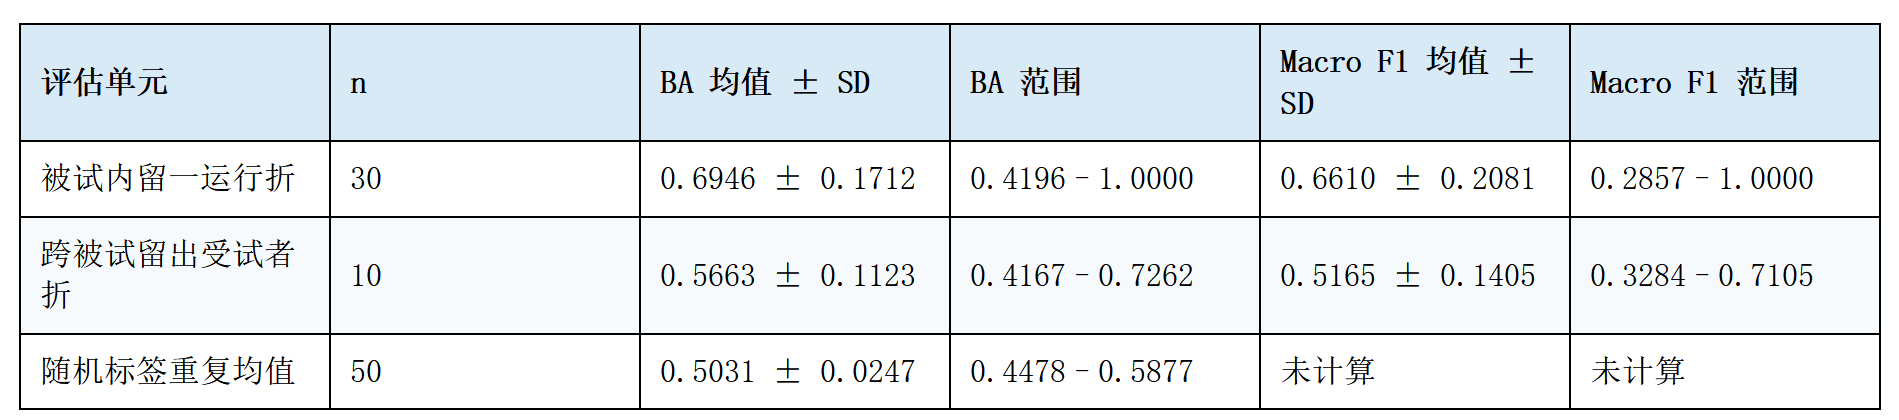
被试内 BA 的 30 个折中有 2 个低于 0.5,跨被试 BA 的 10 个折中有 4 个低于 0.5。10/10 与 6/10 的结论来自被试级均值,折级分布需要单独查看。每位受试者仍贡献 45 个 epoch,两类样本计数为 21–24;这一范围解释了采用 BA 的原因。
混淆矩阵还提供了另一种汇总口径。聚合后双手为 124/224 判对,双脚为 130/226 判对,行归一化召回率分别为 0.5536 和 0.5752。按这张聚合矩阵计算的 pooled BA 为 0.5644;它与 10 个留出受试者 BA 的等权平均 0.5663 略有差异,差异来自汇总顺序和样本权重定义。
随机标签路径固定跨被试折分,每次置换训练标签,重复 50 次。50 个重复均值的平均 BA 为 0.5031,SD 为 0.0247,范围为 0.4478–0.5877,2.5%–97.5% 分位区间为 0.4530–0.5434。观察到的跨被试 BA 为 0.5663,落在这组重复均值的上方;50 次中有 1 次均值达到或超过观察值,单侧经验 p 值按 p=(1+1)/(50+1)=0.0392 计算。
用图 5 查看随机标签重复的分布:
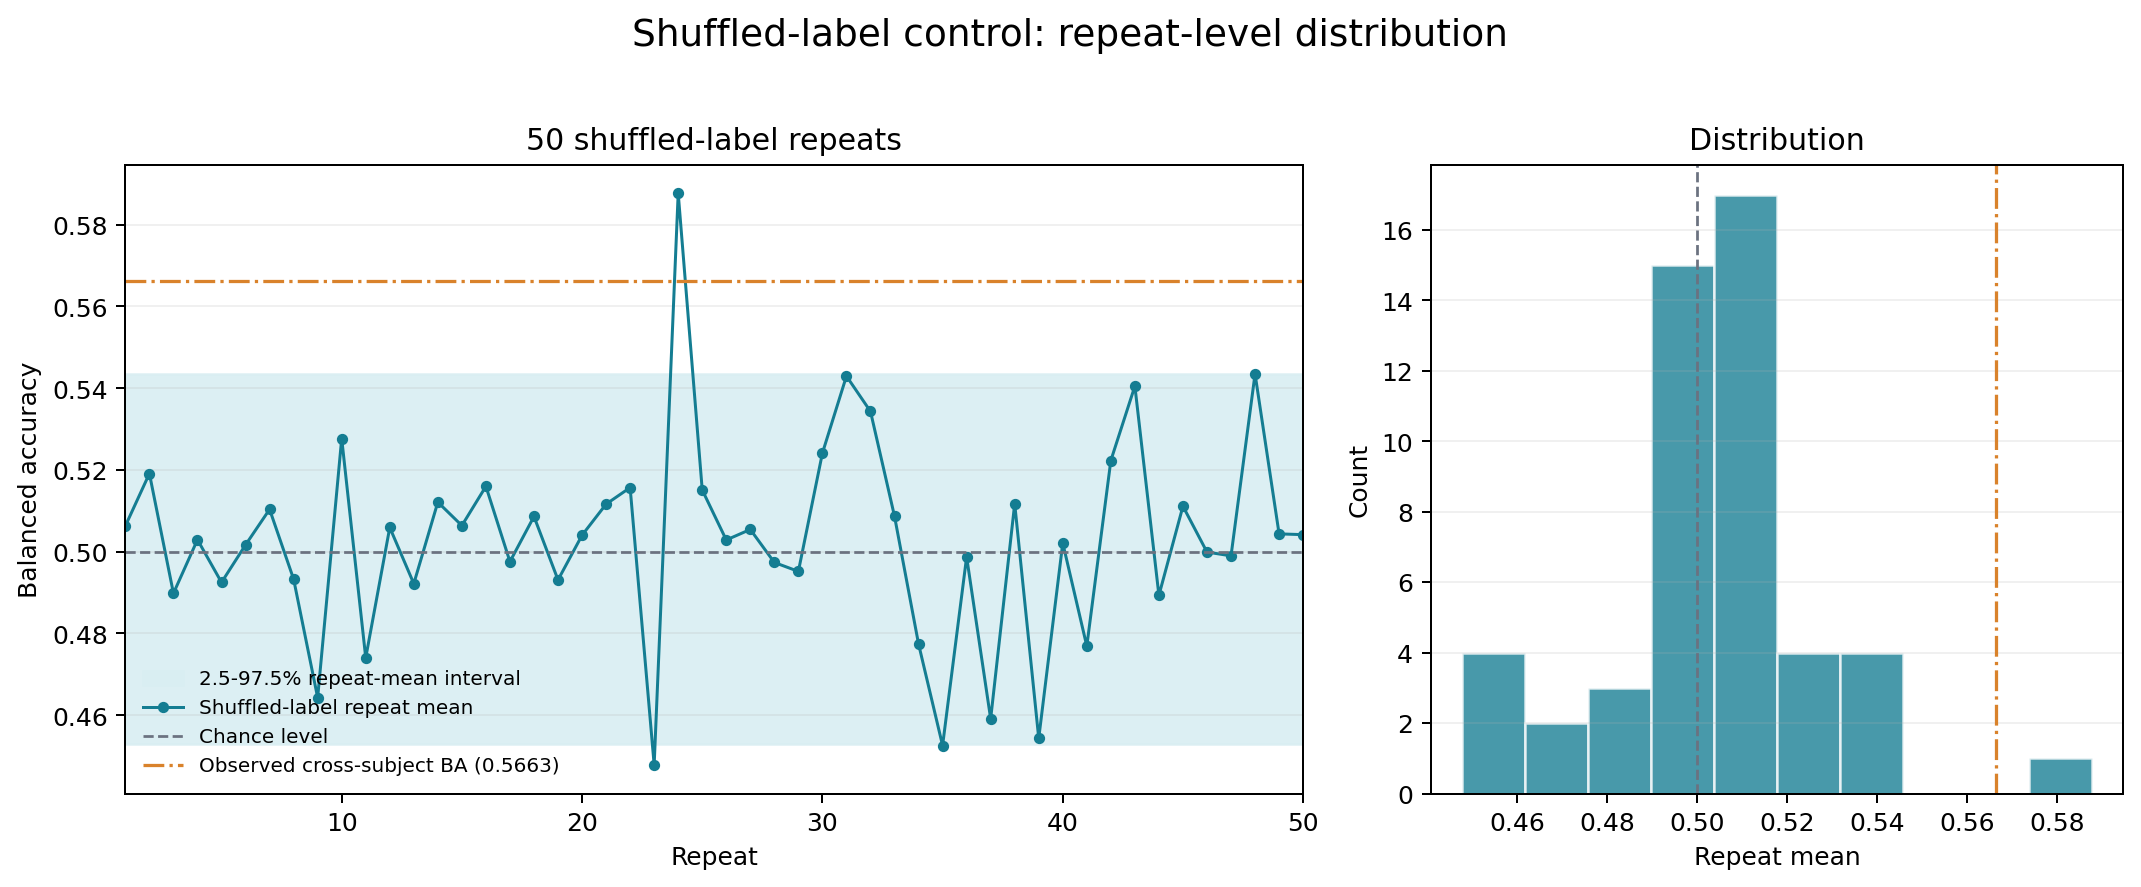
随机标签结果支持一个有限判断:当前流程的跨被试均值高于大多数随机标签重复。误差来自哪些通道、频带或个体因素仍需通过对齐、频谱或消融实验逐项检验。
聚合混淆矩阵先回答整体类别行为。双手样本中 124/224 判对,双脚样本中 130/226 判对,两类召回率在聚合层面接近。下面查看图 6:
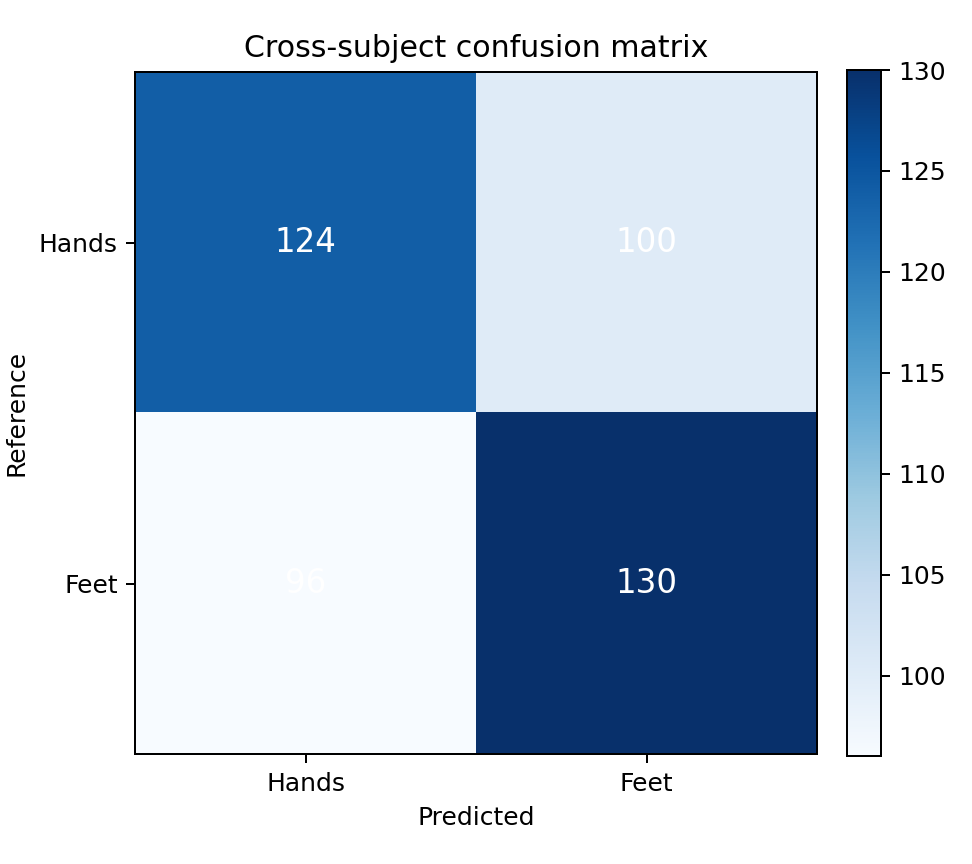
被试级行为更加异质。S005 的矩阵为 [[22, 1], [22, 0]],双脚召回率为 0;S007 的矩阵为 [[1, 21], [0, 23]],双手召回率约 0.0455。表 2 已列出十名受试者的两类召回率,读者可以从聚合读数回到具体个体。
以PhysioNet EEGMMIDB数据集10名受试者的30份EDF记录为基础,搭建了包含EEG读取、7-30Hz带通滤波、事件分段、4分量CSP特征提取和LDA分类的完整管线,设计了被试内留一运行、跨被试留一受试者、随机标签对照三类评估路径,统一使用平衡准确率(BA)作为核心评估指标。本文完成了基于公开EEG数据集的运动想象离线解码全流程实践,建立了CPU可运行的CSP+LDA基线方案。本次实践完整覆盖了脑机接口运动想象解码从数据预处理到结果验证的全环节。
•PhysioNet EEG Motor Movement/Imagery Dataset:https://physionet.org/content/eegmmidb/
•MNE-Python EEGBCI 与 CSP 解码文档:https://mne.tools/stable/auto_examples/decoding/decoding_csp_eeg.html
•scikit-learn 交叉验证说明:https://scikit-learn.org/stable/modules/cross_validation.html