AI类应用
>
最佳实践
>
应用类
>
基于国产异构加速卡的数据驱动油藏历史拟合实践报告
油藏历史拟合通常需要反复调用高保真油藏数值模拟器,对大量地质模型进行生产动态计算与参数更新,计算开销较高。将深度学习代理模型与历史拟合优化流程迁移到国产异构加速环境,需要同时解决 PyTorch 模型在异构加速卡平台上的运行适配、训练环境配置以及代理模型与历史拟合程序协同运行等问题。
本次实践基于国产异构加速计算环境,完成了数据驱动油藏历史拟合流程的部署与验证。其中,生产动态代理模型采用改进型视觉Transformer神经网络(Improved Vision Transformer Neural Network,IViT-NN,以下简称IVIT)[1],历史拟合优化参考基于拥挤竞争机制的多峰分布估计算法(MCEDA)[2]。本次实践重点开展上述方法在国产异构加速环境下的部署、运行与验证,涵盖代理模型训练、SVD地质参数降维、历史拟合优化及后验模型高保真复核等流程。
实践验证了国产异构算力支撑数据驱动油藏历史拟合任务的可行性,实现了深度学习代理模型训练与大规模历史拟合计算在国产异构加速卡平台上的稳定运行,并通过后验模型的高保真数值模拟重新评价进一步验证历史拟合结果。完整记录环境配置、模型训练、历史拟合运行及结果验证过程,可为基于国产异构加速计算平台开展油藏代理建模、自动历史拟合及相关智能油藏模拟任务提供可复用的工程参考。
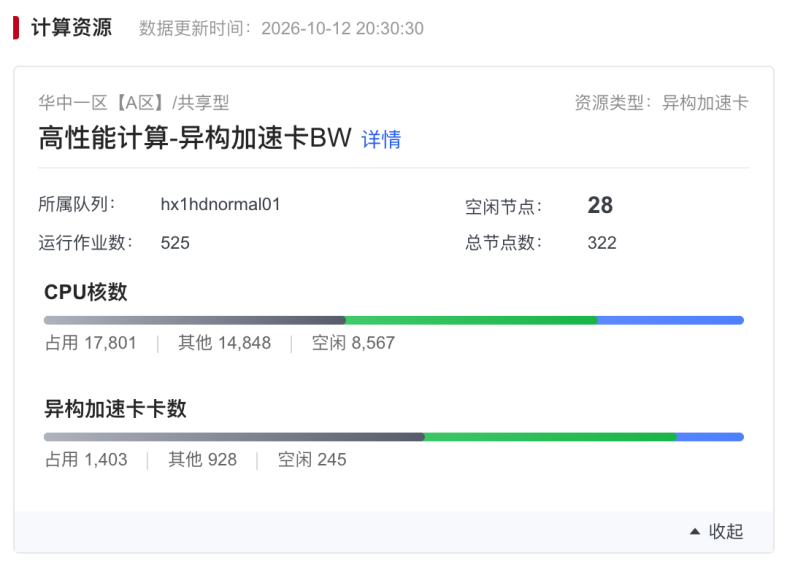
本次实践基于超算互联网平台的高性能计算异构加速卡 BW 资源开展,所属运行队列为 hx1hdnormal01。计算节点采用国产 CPU 与异构加速架构,在此基础上创建独立的 history-matching Python 环境,并配置 DTK 25.04.2 软件栈和 PyTorch 2.5.1,为后续 IVIT 生产动态代理模型训练及 MCEDA 历史拟合任务提供异构计算环境。
本次IVIT代理模型训练和MCEDA历史拟合作业均采用单节点、单卡运行方式,每个作业申请1个计算节点,数据预估占用32G内存,未使用跨节点分布式计算。
使用lscpu、hy-smi--showmemuse--showmemavailable、df-h、free-h等命令查看计算节点的 CPU、异构加速卡、存储及内存资源信息,并确认服务器硬件环境及加速设备状态。
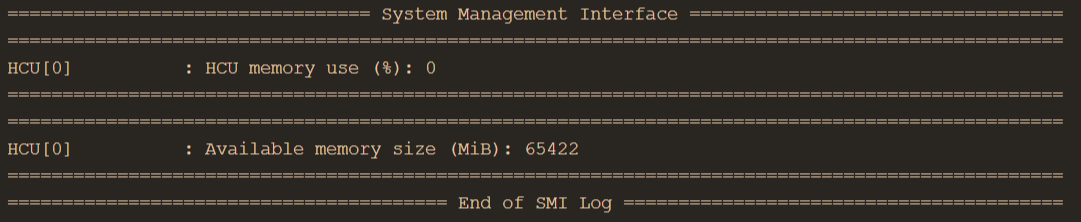
可见计算节点配备国产异构加速设备,当前分配的加速卡可用显存约为 64 GB。
下面需要在该环境上配置并跑通 IVIT 生产动态代理模型及 MCEDA 数据驱动历史拟合程序。
国产异构加速卡通过 DTK 软件栈提供 PyTorch 运行支持。配置完成后,可通过 PyTorch 的兼容接口识别并调用底层异构设备,因此原有基于 PyTorch 编写的代理模型代码无需进行大规模改写即可迁移运行。
与传统 NVIDIA GPU 环境相比,国产异构加速卡使用独立的软件栈和运行环境,因此在迁移过程中需要首先确认 PyTorch、DTK 与底层加速设备之间的兼容性。通过独立环境配置和设备识别测试,可以在不改变 IVIT 主要模型代码的情况下完成国产异构加速卡环境适配。
本次实践采用独立的 history-matching 运行环境,并配置 DTK 25.04.2、PyTorch 2.5.1 等依赖,首先完成国产异构设备识别与基础张量计算验证,再进一步开展 IVIT 模型训练及历史拟合任务。
为避免不同项目之间的 Python 版本及依赖包相互影响,本次实践采用 Miniconda 创建独立的历史拟合运行环境。首先加载已安装的 Miniconda 环境,在此基础上创建名为 history-matching 的 Python 3.10 虚拟环境,并对 pip、setuptools 和 wheel 等基础工具进行更新,为后续 DTK、PyTorch 及历史拟合项目相关依赖的安装提供独立且稳定的软件环境。
source ~/work/miniconda3/bin/activate

conda create -n history-matching python=3.10 pip -y
conda activate history-matching

python -m pip install --upgrade pip setuptools wheel
环境创建完成后,后续 DTK 软件栈、国产异构加速卡版本 PyTorch 以及历史拟合程序相关 Python 依赖均在 history-matching 环境中统一配置。
完成独立 Python 环境创建后,需要进一步配置面向国产异构加速卡的深度学习运行环境。本次实践首先加载平台提供的 DTK 软件栈,并安装与当前 DTK 版本相匹配的国产异构加速卡适配版 PyTorch。
DTK 为 PyTorch 提供面向国产异构加速卡的运行支持,使原有基于 PyTorch 编写的深度学习程序能够通过兼容接口调用底层异构加速设备。为避免使用官方 PyTorch 包导致运行环境与国产异构加速卡软件栈不匹配,本次实践采用平台提供的适配版 PyTorch 安装包完成环境配置。
module load compiler/dtk/25.04.2
python -m pip install ./torch-2.5.1+das.opt1.dtk25042-cp310-cp310-manylinux_2_28_x86_64.whl
PyTorch 安装完成后,根据历史拟合项目运行需求进一步安装 SciPy、h5py、Matplotlib、PyYAML、tqdm 等常用科学计算与数据处理依赖,并将 NumPy 固定为与当前程序兼容的版本。
python -m pip install scipy h5py matplotlib pyyaml tqdm
python -m pip install --force-reinstall "numpy==1.26.4"
至此,历史拟合项目所需的 DTK、PyTorch 及基础 Python 依赖配置完成,为后续国产异构设备识别测试和 IVIT 代理模型运行提供软件环境基础。
完成 DTK 与国产异构加速卡适配版 PyTorch 环境配置后,进一步对深度学习框架与底层异构加速设备之间的连接状态进行验证。通过 PyTorch 提供的设备接口检查加速设备可用状态、设备数量及设备名称,并在国产异构加速卡上执行基础张量运算和矩阵乘法测试,验证计算任务能够实际调度至加速设备执行。
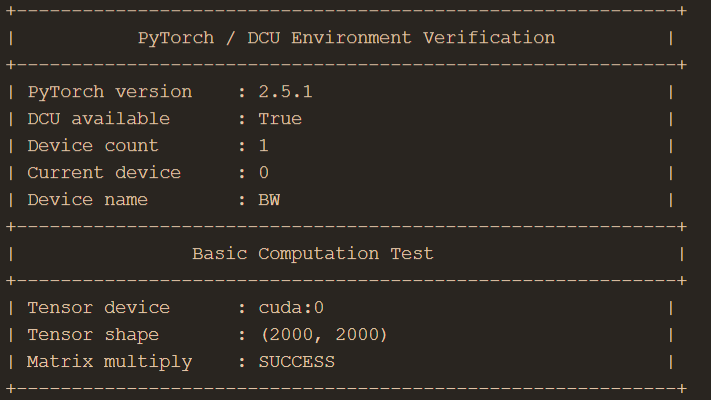
测试结果表明,PyTorch 能够正常识别并调用国产异构设备,基础张量创建及矩阵乘法计算均可正常完成,说明当前 DTK、PyTorch 与底层国产异构加速卡运行环境配置正确,可继续开展 IVIT 代理模型训练及历史拟合计算。
完成 PyTorch 与国产异构设备识别测试后,将数据驱动历史拟合项目部署至计算平台。项目主要包括 IVIT 生产动态代理模型、SVD 地质参数化、MCEDA 历史拟合优化以及相关数据处理模块。为保证后续训练和历史拟合任务能够正常执行,首先对项目路径、Python 依赖和训练数据进行基础运行验证。
本次实践的历史拟合项目部署于独立工作目录,并使用 HDF5 文件统一存储代理模型训练所需的地质参数和生产动态数据。在正式提交训练任务前,对项目目录、数据文件及样本维度进行检查,确认数据能够正常加载。
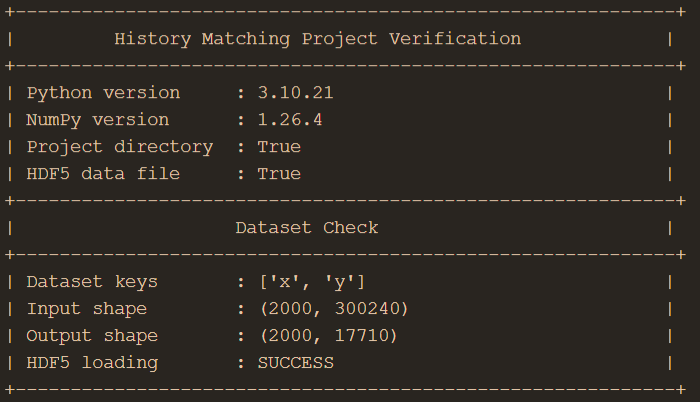
测试结果表明,历史拟合项目目录和训练数据文件均能够正常访问,HDF5 数据读取正常,输入数据维度为 (2000, 300240),输出数据维度为 (2000, 17710),说明项目运行环境及数据读取流程配置正确,可进一步开展 IVIT 代理模型训练。
本次实践采用预先生成的油藏数值模拟样本作为 IVIT 生产动态代理模型的训练数据。每个样本由油藏地质参数与对应的生产动态响应组成,其中地质参数作为代理模型输入,油藏数值模拟得到的生产动态作为监督学习输出。训练数据统一存储为 HDF5 格式,便于在模型训练过程中进行批量读取和数据管理。
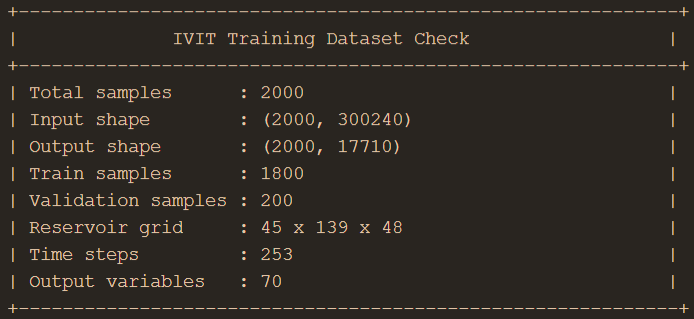
本次使用的数据集共包含 2000 个样本,输入数据维度为 (2000, 300240),输出数据维度为 (2000, 17710)。其中,输入数据进一步按照三维油藏网格组织为 45 × 139 × 48,输出生产动态对应 253 个时间步和 70 个生产响应变量。
在模型训练过程中,将 2000 个样本划分为 1800 个训练样本和 200 个验证样本。训练集用于 IVIT 模型参数更新,验证集用于监测模型在未参与训练样本上的预测误差和泛化性能,并据此保存训练过程中性能最优的模型权重。
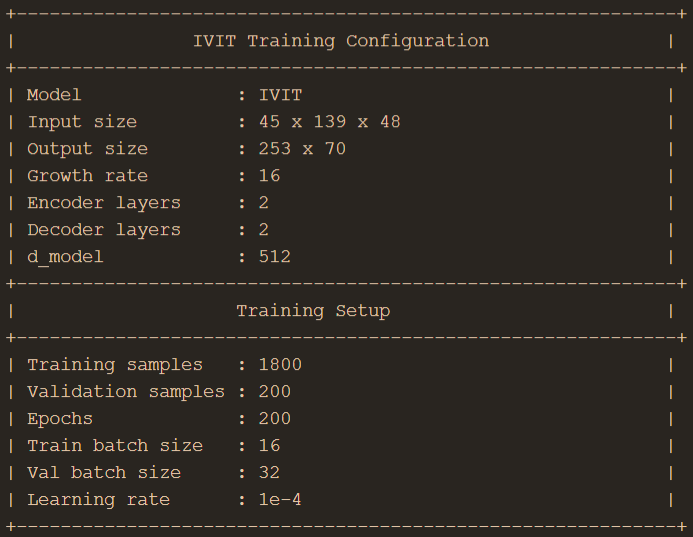
本次实践采用 IVIT 作为油藏生产动态代理模型,用于建立高维地质参数与生产动态响应之间的非线性映射关系。模型输入为三维油藏地质参数场,输入尺寸为 45 × 139 × 48;输出为各生产井在不同时间步下的生产动态数据,输出尺寸为 253 × 70。
IVIT 模型主要参数包括 growth_rate=16、编码器层数 n_encoder=2、解码器层数 n_decoder=2 以及特征维度 d_model=512。训练过程中采用 1800 个样本进行模型参数更新,200 个样本用于验证模型性能。
模型共训练 200 个 epoch,训练批大小设置为 16,验证批大小设置为 32,初始学习率设置为 1×10^-4。训练过程中持续记录训练损失、验证损失、决定系数 R² 以及 RMSE 等指标,并根据验证集性能保存最优模型权重,为后续历史拟合阶段提供生产动态快速预测模型。
完成模型及训练参数配置后,将 IVIT 代理模型训练任务提交至国产异构加速卡计算节点运行。训练过程中持续记录训练集和验证集损失,同时计算 R² 和 RMSE 等指标,用于监测模型收敛过程和验证集预测性能。根据验证集性能自动保存最优模型权重,最终生成 best.pt 供后续历史拟合阶段调用。
随着训练迭代进行,模型训练损失和验证损失总体逐渐下降,R² 逐步提高并趋于稳定。训练至第 200 个 epoch 时,训练集 Loss 为 0.000069,R² 为 0.999472;验证集 Loss 为 0.001088,R² 为 0.991660,RMSE 为 0.032971。
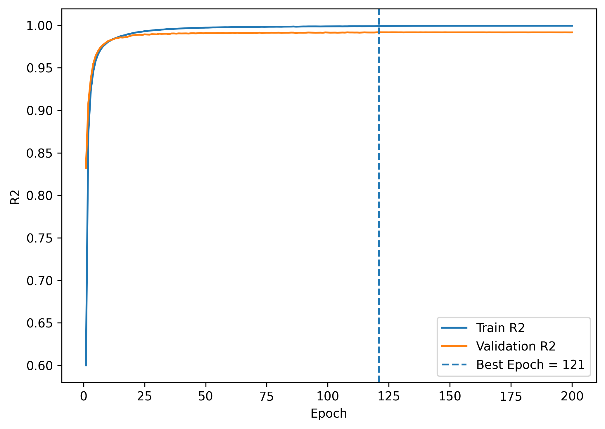
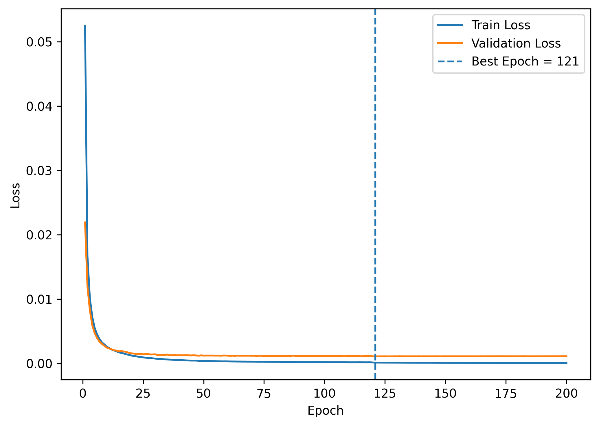
训练过程中验证集性能最优结果出现在第 121 个 epoch,对应验证集 R² 为 0.991808。重新加载保存的最优模型进行验证后,验证集 R² 为 0.991807,RMSE 为 0.032678。结果表明,训练得到的 IVIT 代理模型能够较好地学习地质参数与生产动态之间的映射关系,可用于后续 MCEDA 历史拟合过程中大量候选地质模型的快速生产动态预测。
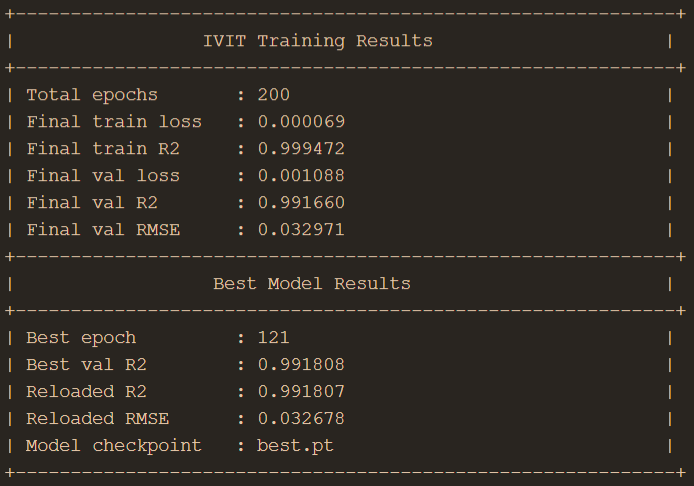
最优模型重新加载后的验证结果与训练过程中记录的最优性能基本一致,说明模型权重能够正常保存和恢复,可进一步作为历史拟合中的快速前向预测模型。
本次IVIT模型训练采用单节点、单张国产异构加速卡,共完成200个epoch。根据作业记录,训练作业总耗时为8分25秒(包含环境初始化、数据加载及模型训练等过程)。根据训练日志统计,第1轮至第200轮的记录时间间隔约为8分钟,平均每轮耗时约2.41秒(包含训练及验证过程)。
本次历史拟合选取 PORO、PERMX、PERMY、PERMZ 和 NTG 5 类地质参数进行 SVD 降维处理。每类参数保留 100 个潜变量,最终得到 500 维潜变量表示,并作为后续 MCEDA 历史拟合的优化变量。
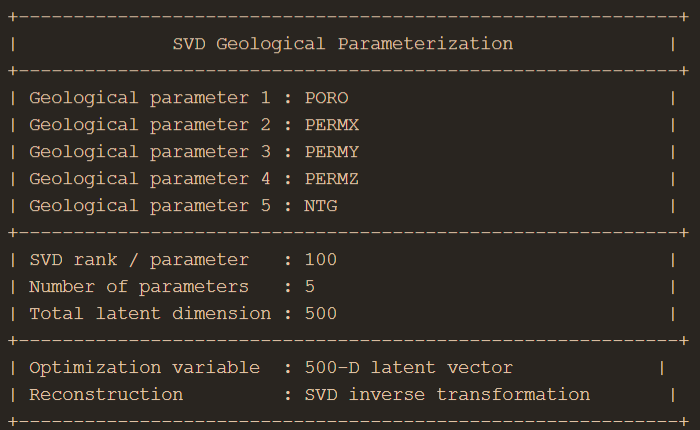
本次历史拟合采用 MCEDA 进行参数优化,种群规模设置为 200,最大迭代代数为 100。初始潜变量按照标准正态分布生成,并限制在 [-3, 3] 范围内。历史拟合过程中调用训练完成的 IVIT 代理模型计算生产动态,并根据目标函数对候选模型进行迭代更新。
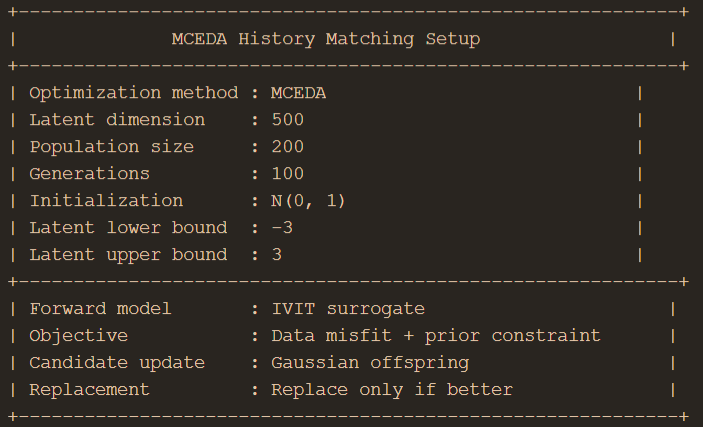
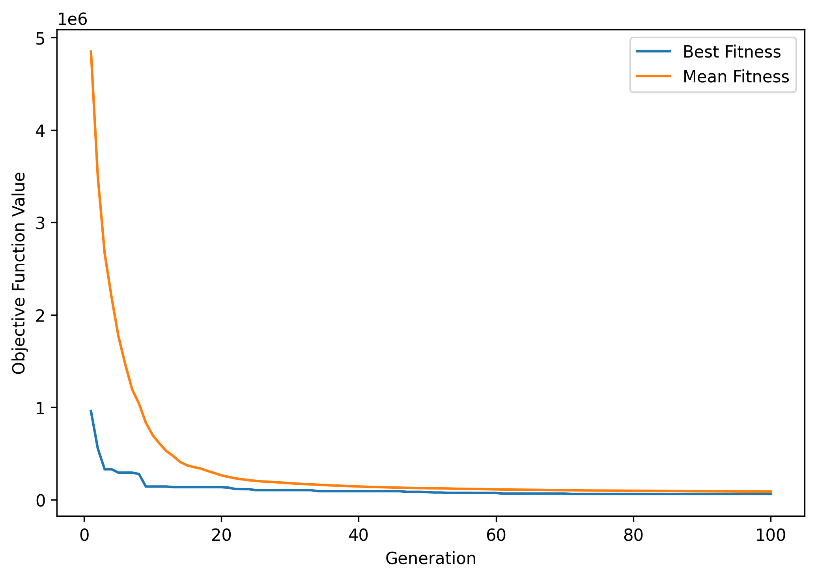
完成参数配置后,启动 MCEDA 历史拟合计算,共进行 100 代迭代。计算过程中记录每一代种群的最优目标函数值和平均目标函数值,用于观察历史拟合过程的收敛情况。
随着迭代进行,目标函数总体呈下降趋势。最优目标函数值由第 1 代的 959250.72 降低至第 100 代的 63880.41,种群平均目标函数值由 4848422.22 降低至 88833.77,表明历史拟合过程逐步收敛。
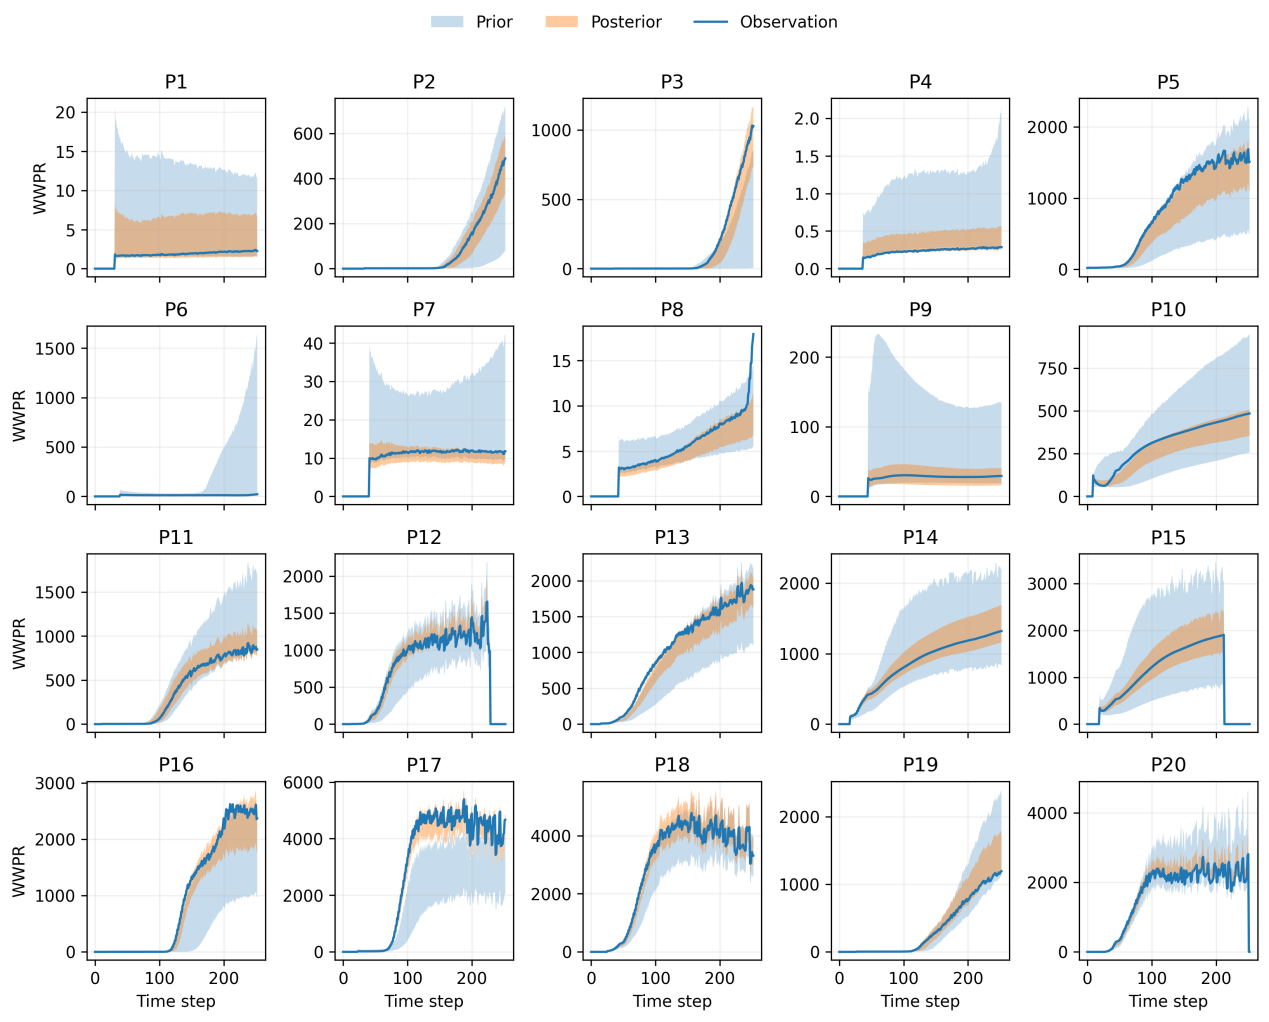
MCEDA 历史拟合完成后,对先验模型集合和后验模型集合的生产动态预测结果进行对比。图中分别给出了各生产井的先验预测范围、后验预测范围以及观测生产数据。
与先验结果相比,后验模型集合的生产动态整体更加接近观测数据,多数生产井的预测范围明显收窄,表明历史拟合有效降低了模型不确定性并改善了生产动态匹配效果。部分井仍保留一定预测离散性,反映出后验模型集合中仍存在一定不确定性。
历史拟合完成后,将200个后验地质模型全部下载至本地,并分别调用Eclipse高保真油藏数值模拟器进行独立计算。根据各模型的高保真生产动态预测结果重新计算历史拟合目标函数,选取目标函数值最小的模型作为Best Eclipse,并对后验地质参数的均值、标准差及代表性模型进行可视化对比。
图中以 PERMX 第 4 层为例,对真实模型、代理模型评价得到的最优模型、Eclipse 高保真评价得到的最优模型、后验均值、后验标准差以及绝对误差进行对比,用于展示历史拟合后地质参数的空间分布及不确定性。
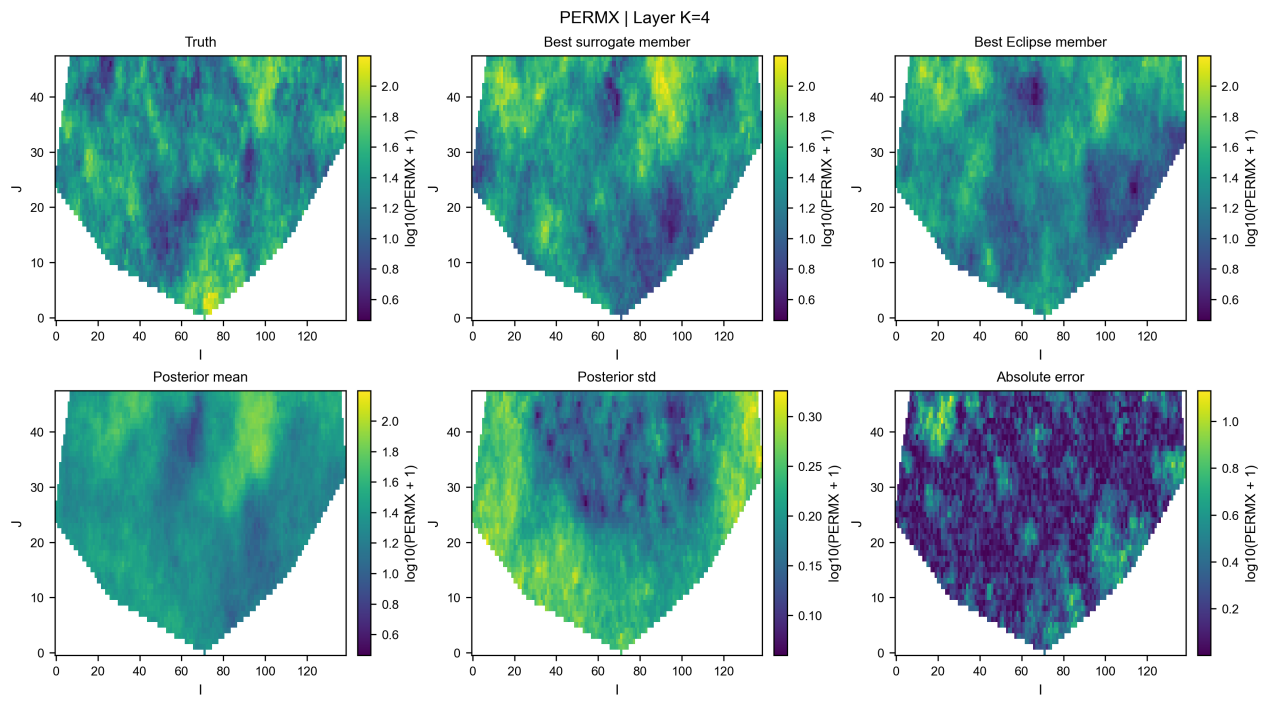
通过代理模型筛选与 Eclipse 高保真复核相结合,对后验模型结果进行了进一步验证,并为最终历史拟合结果评价提供依据。
本次实践基于国产异构计算环境,完成了数据驱动油藏历史拟合流程的部署与运行验证。首先完成 DTK、PyTorch 及相关 Python 依赖配置,并验证了 PyTorch 对国产异构设备的正常识别与调用。
在此基础上,完成 IVIT 生产动态代理模型训练,最优验证集 R² 达到 0.9918 左右,并将训练得到的代理模型用于后续 MCEDA 历史拟合。历史拟合过程中,对 PORO、PERMX、PERMY、PERMZ 和 NTG 等地质参数进行 SVD 降维,并在 500 维潜变量空间中完成 100 代 MCEDA 优化。
历史拟合结果表明,目标函数总体明显下降,后验模型集合的生产动态预测结果较先验模型更加接近观测数据。最后,将200个后验模型下载至本地,并通过 Eclipse 高保真油藏数值模拟进行独立复核,进一步验证了历史拟合结果。
本次实践形成了从国产异构加速卡环境配置、代理模型训练、历史拟合优化到后验模型高保真复核的完整工作流程,可为国产异构计算平台上的数据驱动油藏模拟与自动历史拟合应用提供参考。
[1] Zhang D,Li H. Efficient Surrogate Modeling Based on Improved Vision Transformer Neural Network for History Matching[J/OL]. SPE Journal,2023,28(06):3046-3062. DOI:10.2118/215856-PA.
[2] Yang Q,Chen W-N,Li Y,等. Multimodal Estimation of Distribution Algorithms[J/OL]. IEEE Transactions on Cybernetics,2017,47(3):636-650. DOI:10.1109/TCYB.2016.2523000.